
Zum Inhalt springen
Kinesis

Changelog · 2026

Was wir 2026 ausgeliefert haben.

Die kundenrelevanten Funktionen und Verbesserungen, die wir jeden Monat veröffentlicht haben, von Januar bis November, die wichtigsten zuerst.

Releases
78
Monate
11
  1. November 2026Bisher

    01

    Ein KI-Debugger, der Ihren Code liest

    Debugging mit KI kann jetzt das GitHub-Repository Ihrer App genau bei dem Commit lesen, dessen Build fehlgeschlagen ist oder der gerade läuft, und zeigt jede gelesene Datei an. Es findet die Ursache eines fehlerhaften Builds in Ihrem Dockerfile, Ihren Paketdateien oder Ihrer Konfiguration, statt Sie zu bitten, diese einzufügen. Ein fehlgeschlagenes Deployment zu beheben dauert einen Chat, und nur Personen, die die App bearbeiten dürfen, erhalten Zugriff auf das Repository.
  2. Oktober 2026

    AAcme IncProjekte · Apps · Grids · AbrechnungMitglieder+ Mitglied einladenAalice@acme.devAdminBesitzerBbob@acme.devEntwicklerCcarol@acme.devEntwicklerDdave@acme.devViewerGridsForschungresearch-gpuProduktproduct-inferenceEine Ansicht für jeden Geschäftsbereich

    01

    Organisationen

    Team-Konten sind da: Projekte, Apps, Grids, Server und Abrechnung gehören Ihrer Organisation, mit Mitgliedern, Rollen, Einladungen und einem Audit-Log. Jeder Geschäftsbereich kann seine eigenen Grids betreiben, während die IT alles in einer Ansicht behält. Onboarding und Offboarding dauern Sekunden.

    Die Anmeldekarte des Portals mit „Continue with Single Sign-On“

    02

    Enterprise Single Sign-On

    Organisationen können SSO mit ihrem Identitätsanbieter aktivieren, ihre Domains verifizieren und SSO für alle Mitglieder verpflichtend machen. Ihr Team meldet sich so an, wie es das bei der Arbeit ohnehin tut. Zugriffe werden zentral gesteuert und automatisch entzogen, wenn jemand das Unternehmen verlässt.

    Ein fehlerhaftes Release ohne Neubau rückgängig machenDeploymentsStatusQuelleGestartetErfolgreichDeployment fehlgeschlagenAdd response cachee4c91a7 mainvor 5 Min.ErfolgreichTune batch sizeb7e21d4 mainvor 2 Std.RollbackErfolgreichAdd chat endpointa1f3c9e maingesternRollbackZurück auf b7e21d4Gleiches Image, sofort neu deploytKein NeuaufbauAktiv

    03

    Rollback mit einem Klick

    Setzen Sie eine über GitHub deployte App sofort auf einen beliebigen früheren Build zurück, ohne neu zu bauen. Ein fehlerhaftes Release ist in Sekunden rückgängig gemacht. Liefern Sie schneller aus, weil Fehler sich günstig beheben lassen.

    GRIDml-researchLimits gelten sofort für laufende AppsRichtlinienKontingente2 GPUs pro Person · 15 Min. KulanzzeitEinContainer-Limits4 CPU-Kerne, 16 GiB Arbeitsspeicher pro ContainerEinRückholung ungenutzter GPUsEntfernen nach 30 Min. Leerlauf · 10 Min. VorwarnungEinFair Share2 h pro Runde · 1 App pro PersonEin

    04

    Richtliniensteuerung für Grids

    Eine neu gestaltete Grid-Seite zeigt jede Richtlinie auf einen Blick: GPU-Limits, Kulanzzeiten, Limits pro Container, Leerlauf-Rückholung und Fair Share. Limits werden live auf laufende Container angewendet. Eigentümer legen die Regeln einmal fest, und Kinesis setzt sie durch.

    05

    Grids, die Ihren Apps folgen

    Starten Sie eine App in einem Grid, bevor dessen Maschinen eintreffen, und sie startet, sobald passende Maschinen beitreten. Spot-Maschinen werden nur angemietet, solange eine laufende App sie benötigt, und eine neue Ansicht „Apps in diesem Grid“ zeigt, welche Apps auf welche Maschinen passen. Besitzer zahlen nicht mehr für GPUs, die keine App nutzt, und Teams stecken nie hinter einer harten Sperre fest.

    06

    Sehen Sie, wer was nutzt

    Die neu gestalteten Seiten „Server“ und „Grids“ zeigen die Hardware jeder Maschine, die aktuelle CPU- und GPU-Auslastung, wessen Apps darauf laufen und wer sie hinzugefügt hat, mit einer Zusammenfassung der gesamten Flotte ganz oben. Beide Seiten laden in Millisekunden, selbst bei großen Flotten, und führen einen vollständigen Audit-Trail. Die IT erhält klare Transparenz über die gesamte Organisation, und Kapazitätsplanung und Kostengespräche beginnen mit Fakten.

    07

    Sicher auf 10.000 Replikate skalieren

    Apps können jetzt bis zu 10.000 Replikate statt bisher 20 ausführen, für große Batch-Jobs und Dienste mit hohem Traffic. Eine neue Spread-Gruppe hält Apps mit demselben Gruppennamen auf verschiedenen Maschinen, sodass der Ausfall einer Maschine nie alle Kopien einer Datenbank oder eines Caches lahmlegt. Teams skalieren, ohne auf Ausfallsicherheit zu verzichten.

    08

    Reibungslosere App-Updates

    Updates ziehen jetzt das neue Image, bevor sie den alten Container stoppen, und jede App kann ihre eigene Karenzzeit beim Herunterfahren festlegen. Der Tab „Deployments“ zeigt einen neuen Build so lange als „Deploying“ an, bis Ihre Server ihn tatsächlich ausführen, sodass „Active“ immer live bedeutet. Updates verursachen weniger Ausfallzeit, und Teams wissen immer, welcher Build gerade läuft.

    09

    Nur zahlen, wenn gemietete Maschinen laufen

    Vom Marktplatz angemietete Spot-Maschinen werden für die Zeit, in der sie offline sind, nicht mehr berechnet. Fällt eine angemietete Maschine aus, gibt das Grid sie frei und mietet eine neue an, sodass Apps weiterlaufen. Kunden zahlen nur für Rechenleistung, die sie tatsächlich nutzen können.

    10

    Gehärtete Sicherheit auf der gesamten Plattform

    Jeder interne API-Aufruf prüft jetzt die Rolle des Aufrufers, Server verifizieren die Identität der Control Plane, bevor sie sich verbinden, und Maschinenschlüssel werden auf der Maschine selbst erzeugt. Diese Änderungen schließen ganze Klassen von Angriffen, bevor jemand sie versuchen kann. Kunden erhalten stärkeren Schutz, ohne etwas ändern zu müssen.

  3. September 2026

    Terminal$ export KINESIS_API_KEY=kn_7Hq2xK9p…$ curl -X POST \https://api.kinesis.network/v1/projects/$PROJECT/apps/$APP/start \-H "Authorization: Bearer $KINESIS_API_KEY"202 Accepted{ "id": "66f2a9c4…", "targetState": "running" }API-SCHLÜSSELci-deploykn_7Hq2xK9p…1 Projekt · 2 Berechtigungenapps:writecompute:spendDOKUMENTIERTOpenAPI 3.1 specapi.kinesis.network/openapi.jsonAppsGridsServer

    01

    Öffentliche REST API und API-Schlüssel

    Alles, was Sie im Portal tun, lässt sich jetzt über eine dokumentierte REST API (inklusive OpenAPI-Spezifikation) mit sicheren API-Schlüsseln automatisieren. Binden Sie Kinesis in Ihre CI/CD-Pipelines, internen Tools und Skripte ein. Infrastructure as Code, ohne die Infrastruktur.

    KI-Assistentmcp.kinesis.networkStelle vLLM auf meinem Grid ml-research bereit, 1 GPUAIcreate_appKinesis-Toolname: "llm-chat"image: "vllm/vllm-openai"gpuCount: 1get_app_statusläuftFertig. llm-chat ist auf ml-research live.GRIDml-researchgpu-node-1llm-chat1 GPUgpu-node-3

    02

    KI-Agenten für Sie deployen lassen (MCP)

    Kinesis hat jetzt einen MCP-Server mit sicherer OAuth-Anmeldung, sodass KI-Assistenten und Agenten Ihre Apps, Grids und Builds bereitstellen und verwalten können. Bitten Sie Ihren Assistenten, ein Modell auszuliefern, und er erledigt es. Das ist der kürzeste Weg von der Idee zur laufenden KI-App.

    GRIDml-researchGPUs pro Person begrenzen4alice@acme.dev2 of 4 GPUsbob@acme.dev4 of 4 GPUs+1carol@acme.dev1 of 4 GPUsStart nicht möglich – GPU-Kontingent des Grids erreichtIhr Kontingent in ml-research: 4 von 4 GPUs genutzt.Die App wartet, bis Platz frei wird.

    03

    Kontingente pro Nutzer in geteilten Grids

    Grid-Eigentümer können begrenzen, wie viele Apps, Instanzen und GPUs jeder Nutzer belegen darf. Nutzer sehen klare Hinweise, wenn sie ein Limit erreichen. Geteilte Kapazität bleibt für jedes Team fair und planbar.

    ZUHAUSE ODER BÜROlab-serverFirewall / NATEingehender Verkehr bleibt gesperrtAusgehender TunnelApp-TrafficKinesisRemote ReachIhre NutzerKeine eingehende Portweiterleitung nötig

    04

    Jede Maschine verbinden, hinter jeder Firewall

    Beim Hinzufügen eines Servers geht es jetzt zuerst darum, wo er angeschlossen ist, und Kinesis empfiehlt die passende Methode, einschließlich Kinesis Remote Reach für Maschinen hinter einer Firewall oder NAT. Sie müssen keine eingehenden Ports öffnen. Büro-PCs, Labore und On-Premises-Server sind in wenigen Minuten sicher eingebunden.

    05

    Integrierte Laufzeitsicherheit

    Cloud-Server führen jetzt standardmäßig einen Sicherheitsmonitor aus, der verdächtige Container-Aktivitäten erkennt, stoppt und Ihnen meldet. Bedrohungen werden abgefangen, während sie passieren, nicht erst nach dem Schaden. Sicherheit gehört zur Grundausstattung.

    06

    Fertige App-Vorlagen

    Starten Sie eine neue App aus einer Vorlage, die bereits das richtige Image, die richtigen Ports und Ressourcen enthält. Gängige Workloads gehen live, ohne dass Sie Dokumentation lesen müssen. Neue Nutzer kommen schneller zu ihrer ersten laufenden App.

    07

    Erfahren Sie, warum eine App nicht läuft

    App-, Server- und Log-Seiten zeigen jetzt Platzierungsprüfungen, Arbeitsaufträge und den Grid-Status an einem Ort. Wenn eine App auf eine Maschine wartet, sehen Sie genau, welche Regel sie zurückhält. Probleme, für die früher ein Support-Ticket nötig war, erkennen Sie jetzt auf einen Blick.

    08

    Windows-PCs in Grid-Kapazität verwandeln

    Spark, die Kinesis-Desktop-App für Windows, verbindet einen PC jetzt mit wenigen Klicks mit Ihrem Konto und lässt Sie ihn pausieren oder einen Zeitplan festlegen. Büro- und Labor-PCs liefern Rechenleistung in den Stunden, in denen sie sonst ungenutzt wären. Die Eigentümer behalten die Kontrolle darüber, wann ihre Maschine arbeitet.

    09

    Secrets bleiben geheim

    Kinesis erkennt jetzt Umgebungsvariablen, die wie Secrets aussehen, und verbirgt ihre Werte in Listen und APIs. Passwörter und API-Schlüssel gelangen nicht über Screenshots oder geteilte Bildschirme nach außen. Bewährte Sicherheitspraxis wird zum Standard.

    10

    Mehr GPUs auf dem Marktplatz

    Spot Instances umfassen jetzt GeForce-Karten ab der RTX 20-Serie sowie Workstation-RTX-GPUs, jeweils mit vollständiger Modellbezeichnung. Kunden erhalten mehr Auswahl in mehr Preisklassen. Kleinere Workloads finden bezahlbare Hardware, die passt.

  4. August 2026

    Deployen Sie die App neu. Die Daten bleiben.my-appv1ErsetztRedeploymy-appv2Läuftgleiche VolumesPersistenter Speicherbis zu 4 pro AppNameMount-PfadGrößemodels/models200 GBDaten bleibendb/var/lib/postgresql50 GBDaten bleibenuploads/data/uploads20 GBDaten bleiben

    01

    Persistente Volumes

    Grid-Apps können jetzt bis zu 4 persistente Speicher-Volumes behalten, die Neustarts und erneute Deployments überstehen. Datenbanken, Modell-Caches und Nutzer-Uploads bleiben sicher. Zustandsbehaftete Workloads laufen auf Kinesis jetzt so einfach wie zustandslose.

    Eine GPU, sieben isolierte SlicesGPU-LayoutGPU 0 — A100 80GB80 GB VRAMMIGMax. AnzahlHälftenGemischtCompute 7/7 · Speicher 7/81g.10gb#0chat1g.10gb#1embed1g.10gb#2ocr1g.10gb#3rerank1g.10gb#4whisper1g.10gb#5vision1g.10gb#6notebookJede App erhält ihren eigenen Anteil an Rechenleistung und Arbeitsspeicher

    02

    GPU-Slicing mit MIG

    Teilen Sie Rechenzentrums-GPUs (A100- und H100-Klasse) mit einem visuellen Layout-Designer in isolierte Slices auf, und geben Sie jeder App ihren eigenen Slice. Eine leistungsstarke GPU kann jetzt viele kleinere Workloads sicher bedienen. Mehr erreichen mit weniger Hardware.

    Ungenutzte GPUs gehen an Apps zurück, die sie brauchenAuslastung GPU 0notebook-atrain-bLeerlauf-Schwellenwert!GewarntZurückgefordertLeerlauf-ZeitfensterKulanzzeitnotebook-aLeerlauf auf der GPUaus diesem Grid verschobenGPU 0train-bLäuftwartete auf eine GPU

    03

    Rückholung ungenutzter GPUs

    Grids können jetzt GPUs von inaktiven Apps zurückholen, mit konfigurierbaren Schwellenwerten und einer klaren Warnung, bevor etwas gestoppt wird. Knappe GPUs gehen zurück an die Personen, die sie aktiv nutzen. Jede GPU, für die Sie bezahlen, leistet echte Arbeit.

    Wenn das Grid voll ist, kommen Nutzer abwechselnd an die ReiheReihenfolge des EingangsFair-Share-WarteschlangeAUser Aapp-1AUser Aapp-2AUser Aapp-3BUser Bapp-1CUser Capp-1AUser Aapp-11BUser Bapp-12CUser Capp-13AUser Aapp-24AUser Aapp-35GridVollnächste freie Maschine2 h pro Runde · 1 App pro Person

    04

    Fair-Share-Scheduling

    Wenn ein Grid voll ist, warten Apps jetzt in einer fairen Warteschlange und kommen abwechselnd an die Reihe, statt nach dem Prinzip „Wer zuerst kommt, mahlt zuerst“. Niemand kann geteilte Kapazität allein in Beschlag nehmen. Jedes Team bekommt automatisch seinen Anteil.

    05

    Superkräfte für Grid-Admins

    Teilen Sie Grids mit den Rollen Editor und User, sehen Sie die aktuelle CPU-, RAM-, GPU- und VRAM-Nutzung jeder App, und stoppen oder starten Sie Apps von einem Bildschirm aus neu. Grid-Besitzer erhalten volle Transparenz und Kontrolle über geteilte Kapazität. Die IT behält die Kontrolle, ohne im Weg zu stehen.

    06

    Aufwecken, das auf Verfügbarkeit wartet

    Wenn eine GPU nicht vorrätig ist, während eine Maschine aus dem Ruhezustand aufwacht, versucht Kinesis es weiter und zeigt Ihnen den Status an, und Eigentümer erhalten eine Benachrichtigung, wenn eine Maschine nicht in den Ruhezustand wechseln kann. Nichts bleibt unbemerkt hängen. Sie können sich darauf verlassen, dass der Ruhezustand Geld spart, ohne Ihre Kapazität zu gefährden.

    07

    Eine Grid-fähige App-Galerie

    Die App Gallery deployt jetzt standardmäßig auf Ihr Grid, wenn Sie eines haben. Modelle und Apps landen auf der Hardware, für die Sie bereits zahlen, ohne zusätzliche Einrichtung. Ihre eigene Rechenleistung zu nutzen, kostet einen Klick.

  5. Juli 2026

    Ihre MaschinenBYOC · ohne AufpreisDedizierte InstanzenAWS · Azure · KinesisSpot InstancesKinesis-MarktplatzGRIDml-research8 onlinegpu-box-1gpu-box-2train-1train-2train-3spot-1spot-2spot-3

    01

    Grids und Spot Instances

    Grids kombinieren jetzt Ihre eigenen Maschinen, On-Demand-Cloud-Maschinen und gemietete Spot Instances vom Kinesis-Marktplatz in einem Pool. Skalieren Sie Rechenleistung in wenigen Minuten hoch und herunter, zu dem Preis, der zu jedem Workload passt. Eine Plattform, eine Ansicht, für jede Art von Rechenleistung, die Sie nutzen.

    SSH-Schlüssel+ Schlüssel hinzufügenMein LaptopSHA256:q3Fv8tXbW2…9kXwAdded Jul 8 · assigned to 3 serversgpu-box-1train-1train-2CI-RunnerSHA256:Lm4cR0aZp7…Qe1dAdded Jul 14 · assigned to 1 servertrain-1Terminal$ ssh -i ~/.ssh/id_ed25519ubuntu@203.0.113.24Welcome to Ubuntu 24.04 LTSLast login: Tue Jul 15ubuntu@train-1:~$

    02

    Eigene SSH-Schlüssel mitbringen

    Laden Sie Ihre SSH-Schlüssel einmal hoch und weisen Sie sie Ihren Cloud- und BYOC-Maschinen für direkten Zugriff zu. Engineers gelangen mit den Tools auf ihre Maschinen, die sie bereits nutzen. Ihre Schlüssel, Ihre Kontrolle.

    Appllm-serveGrid-Priorität1ml-research2burst-poolGRIDml-researchMaschinen priorisieren1gpu-box-1Bevorzugtllm-serve2gpu-box-2Normal3spot-1Nur BackupÜberlaufGRIDburst-pool

    03

    Workloads genau dort platzieren, wo Sie sie haben wollen

    Ordnen Sie Maschinen innerhalb eines Grids nach Priorität und lassen Sie eine App über mehrere Grids hinweg laufen. Ihre bevorzugte Hardware übernimmt die Arbeit zuerst, und der Rest der Flotte steht für den Überlauf bereit. Intelligentere Platzierung bedeutet bessere Performance und niedrigere Kosten.

    04

    Mehrere Domains pro App

    Eine App kann jetzt mehrere eigene Domains bedienen, einschließlich Root-Domains (Apex) wie yourcompany.com. Betreiben Sie regionale Websites, Markenvarianten oder Migrationen aus einem einzigen Deployment. Jede Domain erhält automatisch SSL.

    05

    Provider Hub: Verdienen Sie mit Ihrer Hardware

    Zugelassene Anbieter können ganze Maschinen auf dem Kinesis-Marktplatz anbieten und ihre Einnahmen im neuen Provider Hub verfolgen. Hardware, die sonst ungenutzt bliebe, finanziert sich jetzt selbst. Mehr Angebot im Netzwerk bedeutet auch mehr Auswahl für alle, die mieten.

    06

    A100-GPUs auf Abruf

    A100-Rechenzentrums-GPUs lassen sich jetzt direkt über die Grids-Seite bereitstellen. Große Trainings- und Inferenzjobs erhalten in wenigen Minuten erstklassige Hardware, ohne langfristigen Vertrag. Sie skalieren für den großen Job hoch und geben die Hardware zurück, wenn Sie fertig sind.

    07

    Geteilte Grids ohne Reibung bei der Abrechnung

    Apps, die auf einem mit Ihnen geteilten Grid laufen, nutzen jetzt die Maschinen dieses Grids ohne zusätzliche nutzungsbasierte Gebühren oder Guthabenprüfungen. Der Grid-Eigentümer bezahlt die Kapazität einmal, und jedes Team nutzt sie frei. Rechenleistung im Unternehmen zu teilen ist endlich so einfach wie das Teilen eines Ordners.

  6. Juni 2026

    Build fehlgeschlagen> npm cinpm ERR! code EUSAGEnpm ERR! missingpackage-lock.jsonDebugging mit KIKinesis AIBetaLogs des fehlgeschlagenen Builds für my-apiWarum ist mein Build fehlgeschlagen?npm ci benötigt package-lock.json, aber dieDas Dockerfile kopiert nur package.json.Vorgeschlagene Konfigurationsänderungen- COPY package.json ./+ COPY package*.json ./ RUN npm ciApp-Änderungen übernehmen

    01

    Kinesis AI, Ihr integrierter DevOps-Assistent

    Im Portal gibt es jetzt einen KI-Assistenten. Er kann Ihre Build-Fehler und App-Logs lesen, erklären, was schiefgelaufen ist, und Korrekturen für Ihr Dockerfile vorschlagen. Die Hilfe kommt sofort, im Kontext und rund um die Uhr, ohne Ticket-Warteschlange.

    Bereitstellung läuftKINESIS · 1x A100In der WarteschlangeSystem wird konfiguriertWird abgeschlossenServer wird registriertKapazität nicht erreichbarVersuch 3 von 3Wir konnten keinen Server beschaffen.Versuchen Sie es jetzt erneut oder wählen Sie eine andere Region.Erneut versuchenVerwerfen

    02

    Transparente Bereitstellung, von Anfang bis Ende

    Maschinen, die gerade bereitgestellt werden, zeigen jetzt den Fortschritt live, Instanzdetails sowie die Optionen „Erneut versuchen“ oder „Verwerfen“, falls etwas fehlschlägt. Sie wissen immer, was passiert und was als Nächstes zu tun ist. Kein Rätselraten mehr, ob die Kapazität kommt.

    APP-STATUSWird heruntergeladenWird gestartetLäuftStart blockiertStart nicht möglich – kein geeigneter KnotenDerzeit erfüllt kein Node die Anforderungen dieser App.gpu-box-1— not enough GPU memoryedge-node-2— not enough GPUs

    03

    Klarere App-Status

    Apps zeigen jetzt präzise Status an, während sie sich ändern, darunter den neuen Status „Start blockiert“, der erklärt, warum eine App nicht starten kann. Kleine Änderungen an einer laufenden App werden nicht mehr grundlos blockiert. Weniger Verwirrung, schnellere Lösungen.

    04

    Schneller lokaler SSD-Speicher ohne Aufpreis

    Cloud-Maschinen können jetzt schnelle lokale SSDs für Images und Container nutzen, und integrierter Instanzspeicher wird nicht mehr separat abgerechnet. Große Modelle laden schneller, und die Kosten sinken. Mehr Leistung für weniger Geld.

    05

    „Nie in den Ruhezustand“ für kritische Maschinen

    Fixieren Sie jede Maschine, damit sie nie automatisch in den Ruhezustand geht. Dauerhaft laufende Dienste bleiben bereit, während der Rest Ihrer Flotte weiter Geld spart. Sie bekommen beides, Einsparungen und Zuverlässigkeit, Maschine für Maschine.

    06

    Eine selbstheilende Traffic-Schicht

    Der Traffic zu Ihren Apps läuft jetzt über eine neu aufgebaute App Proxy-Schicht, die ihren eigenen Zustand prüft und Routen sowie Zertifikate automatisch repariert. Ihre Endpunkte bleiben erreichbar, selbst wenn ein Teil des Netzwerks einen schlechten Tag hat. Die Zuverlässigkeit steigt, ohne dass Sie etwas ändern müssen.

    07

    Große Flotten mühelos verwalten

    Eine neue Listenansicht für Grids und Server bietet Suche, Seitenumbruch und eine Ansicht pro App. Teams mit Hunderten Maschinen finden die gesuchte in Sekunden. Das Portal wächst mit Ihrer Flotte.

  7. Mai 2026

    Projekt teilenWählen Sie, wer ml-research öffnen darf.dana@acme.devEntwicklerEinladung sendenHINZUGEFÜGTBbob@acme.devEntwicklerCcarol@acme.devViewer1alice@acme.devhat Sie zum Projekt hinzugefügt"ml-research"In der App und per E-Mail

    01

    Projekte und Apps mit Ihrem Team teilen

    Laden Sie Mitwirkende mit der passenden Rolle zu jedem Projekt oder jeder App ein und halten Sie alle mit In-App- und E-Mail-Benachrichtigungen auf dem Laufenden. Teams arbeiten gemeinsam an einem Ort, statt Logins zu teilen. Zugriffe sind klar geregelt, und Sie können sie jederzeit entziehen.

    Zwei-Faktor-AuthentifizierungGeben Sie den 6-stelligen Code aus IhrerAuthenticator-App ein.48291Diesen Browser 30 Tage lang merkenBestätigenODERPasskey verwendenTouch ID, Windows Hellooder einem SicherheitsschlüsselBackup-Code verwenden••••-••••••••-••••••••-••••••••-••••

    02

    Zwei-Faktor-Authentifizierung und Passkeys

    Schützen Sie Ihr Konto mit einer Authenticator-App oder einem Passkey/Sicherheitsschlüssel, mit Backup-Codes und vertrauenswürdigen Geräten. So bleiben Ihre Workloads und Ihre Abrechnung sicher, selbst wenn ein Passwort durchsickert. Sicherheit auf Enterprise-Niveau, die sich in Sekunden aktivieren lässt.

    QuelleGitHubDockerHubDocker-LinkHochladenTARmy-model.tarWird hochgeladen... 64%docker save -o my-model.tar my-modelUpload abgeschlossenmy-model.tarApp erstellenLäuftKeine Registry nötig

    03

    Bereitstellung per Upload

    Laden Sie eine Docker-Image-Datei direkt zu Kinesis hoch und deployen Sie sie. Keine Registry nötig. Air-Gapped-Builds, private Modelle und Teams ohne Registry können jetzt mit einem einzigen Upload ausliefern.

    04

    Server-Onboarding mit einem Token

    Binden Sie eigene Rechenleistung mit einem einzigen Installationsbefehl und einem persönlichen Token ein, das Sie jederzeit neu generieren können. Einen Server hinzuzufügen dauert eine Minute, und der Zugriff bleibt unter Ihrer Kontrolle. Von einer auf hundert Maschinen zu skalieren ist so einfach wie das Ausführen eines Befehls.

    05

    Vollständiger Aktivitätsverlauf

    Jedes Projekt und jede App hat jetzt einen Aktivitätsverlauf, der zeigt, wer was wann geändert hat. Teams können jede Änderung in Sekunden nachvollziehen. Audits und Post-Mortems werden einfach.

    06

    Abrechnung für Unternehmen

    Zahlen Sie per Karte, Überweisung oder ACH, erhalten Sie Rechnungen, die jede Maschine auflisten, und laden Sie alle Ihre Kosten und Gutschriften als CSV herunter. Finanzteams erhalten die nötigen Unterlagen, ohne den Support fragen zu müssen. Kinesis passt jetzt zur Art, wie größere Unternehmen einkaufen.

    07

    Logs aller Instanzen nebeneinander

    Streamen Sie Logs mehrerer Instanzen einer App gleichzeitig, in Tabs, die Sie selbst anordnen. Probleme, die nur auf einer Maschine auftreten, sind leicht zu erkennen. Das Debuggen hochskalierter Apps bedeutet nicht mehr, zwischen Seiten hin und her zu springen.

  8. April 2026

    Server hinzufügen1× H100 80GBGPU · 26 vCPUsHOHE NACHFRAGE1× A100 80GBGPU · 28 vCPUs1× L40S 48GBGPU · 16 vCPUsIn Warteschlange für verfügbare InstanzDANNIn der WarteschlangeKein NeuladenBeschafftautomatischE-Mail beies bereit ist

    01

    Live-Bestand und Vorbestellung

    Sehen Sie die aktuelle GPU- und CPU-Verfügbarkeit, bevor Sie bereitstellen, mit Hinweisen auf „hohe Nachfrage“. Ist eine Maschine nicht verfügbar, können Sie sie trotzdem bestellen, und Kinesis besorgt sie für Sie, sobald sie frei ist. Kein ständiges Neuladen mehr, um eine freie GPU zu erwischen.

    my-appQuelleLaufzeitNetzwerkAusführungRessourcenAusführungsmodellDienstAPIs, InferenzEndpointsAufgabenLaufen bisAbschlussGeplantFester ZeitplanDemnächst verfügbarRessourcenRechenleistungNeues GridVorhandenes Grid verwendenServerless

    02

    Apps einfacher konfigurieren

    Die App-Einrichtung hat jetzt übersichtliche Tabs für Ausführung und Compute-Strategie mit Auswahlkarten. Sie beschreiben, wie Ihre App laufen soll, und Kinesis kümmert sich um die Hardwaredetails. Neue Nutzer kommen schneller zu einem funktionierenden Deployment, und Experten behalten die volle Kontrolle.

    LAUFZEIT≈ 12 TageLaufzeit verbleibt auf Ihrem GuthabenE-MailSchützenheute48h2hSchutz bei niedrigem GuthabenSchwellenwert für den Ruhezustand2 StundenNoch etwa 48 h Laufzeitauf Ihrem GuthabenErneut bei 24 h, 12 h und 1 h,bevor Ihr Guthaben aufgebraucht ist

    03

    Vorausbezahlte Laufzeit und Node-Schutz

    Sehen Sie, wie lange Ihr Guthaben Ihre Maschinen noch am Laufen hält, schützen Sie kritische Maschinen vor dem automatischen Herunterfahren und erhalten Sie frühzeitig Warnungen per E-Mail. Keine überraschenden Ausfälle mehr wegen eines zu niedrigen Guthabens. Vorausplanen wird einfach.

    04

    Selbstheilende Maschinen

    Maschinen mit einem kritischen Fehler starten jetzt selbstständig neu und erholen sich, und Sie können eine fehlerhafte Maschine mit einem Klick durch eine neue ersetzen. Ihre Apps fallen seltener aus, und Ihr Team verbringt weniger Zeit mit Support. Zuverlässigkeit ohne ständige Aufsicht.

    05

    Volle Kontrolle über Ihre Logs

    Legen Sie fest, wie lange Logs aufbewahrt werden, laden Sie sie herunter oder löschen Sie sie, durchsuchen Sie den Verlauf und sehen Sie sich die Systemlogs einer Maschine im Portal an. Debugging dauert Minuten statt SSH-Sitzungen. Sie entscheiden, wie viele Daten Sie aufbewahren, aus Kosten- und aus Compliance-Gründen.

    06

    Die neuesten offenen Modelle, sofort einsatzbereit

    Die App Gallery hat die neuesten offenen Modelle aufgenommen, darunter Gemma 4, Qwen 3.5 und Qwen 3.6. Teams probieren neue Modelle mit einem Klick in der Woche aus, in der sie erscheinen. Bei Open-Source-KI auf dem neuesten Stand zu bleiben, erfordert keinen zusätzlichen Engineering-Aufwand.

    07

    Private Registries leicht gemacht

    Stellen Sie aus privaten Docker-Registries bereit, mit Zugangsdaten, die Kinesis prüft, bevor Ihre Änderungen gespeichert werden. Ein falsches Passwort zeigt sich im Formular, nicht als defekte App. Private Images lassen sich so einfach ausliefern wie öffentliche.

  9. März 2026

    Dedizierte RechenleistungCloud-AnbieterAWSAzureKinesisGPUCPUInstanztypg5.xlarge1× A10G GPURegionUS East (N. Virginia)Gridml-researchIhre MaschineBYOCIhre MaschineBYOCg5.xlargeAWSBeigetretenIhre Maschinen + Cloud, ein Grid

    01

    Cloud-Maschinen direkt im Portal starten

    Grids stellen jetzt AWS-, Azure- und Kinesis-Cloud-Maschinen bei Bedarf direkt aus dem Portal bereit, mit GPU- und CPU-Optionen nebeneinander. Keine separaten Cloud-Konten oder Konsolen zu verwalten. Ihre eigene Hardware und On-Demand-Cloud-Kapazität befinden sich an einem Ort.

    https://app.yourcompany.comYYourCompanyDNS verifiziertEintrag gefundenZertifikat ausgestelltSSL wird für Sie erledigtVerlängert sich automatischKeine bösen Überraschungen beim Ablauf

    02

    Ihre Domain, automatisches SSL

    Verbinden Sie Ihre eigene Domain mit jeder App, und Kinesis stellt das SSL-Zertifikat für Sie aus und verwaltet es. Ihre Nutzer sehen Ihre Marke, nicht unsere. Nie wieder Zertifikatspflege.

    GPUs einmal kaufen, mit jedem Team teilenIT-AdminBesitzerKauft Kapazität einmalGridgpu-gridGPU 1ABGPU 2CAGPU 3BGPU 4CBTeam AGeteilt · führt Apps ausTeam BGeteilt · führt Apps ausTeam CGeteilt · führt Apps aus

    03

    Geteilte Grids

    Grid-Eigentümer können ihre Maschinen jetzt mit anderen Nutzern und Teams teilen. Ein IT-Administrator kann Kapazität einmal kaufen und jedem Team Zugriff darauf geben. Teure GPUs werden von allen genutzt, die sie brauchen, statt an ein Konto gebunden zu sein.

    04

    Ruhezustand, Aufwecken und Neustart zu Ihren Bedingungen

    Versetzen Sie Maschinen mit einem Klick in den Ruhezustand, wecken Sie sie auf oder starten Sie sie neu, mit klarem Status bei jedem Schritt. Sie entscheiden, wann Sie Geld sparen und wann Kapazität bereitstehen soll. Mit einfachen Steuerelementen behalten Sie die Kontrolle, ganz ohne SSH oder Skripte.

    05

    Eine Rechnung für Ihre gesamte Rechenleistung

    Dedizierte Maschinen zeigen ihren Preis jetzt vorab, fließen in eine Kostenübersicht der Flotte ein und erscheinen auf denselben Rechnungen wie alles andere. Finanzteams sehen eine klare Rechnung statt mehrerer. Sie wissen immer, was Ihre Flotte kostet, bevor die Rechnung kommt.

    06

    Nie wieder ein veraltetes Image ausführen

    Kinesis erkennt jetzt, wenn ein Docker-Tag auf ein neues Image zeigt, und bietet an, die neueste Version zu pullen. Sie wissen immer, ob Ihre App den Code ausführt, den Sie gerade gepusht haben. Schluss mit Redeploys, die stillschweigend den alten Build behalten.

    07

    Intelligentere Container-Einrichtung

    Das App-Formular schlägt jetzt Ports aus Ihrem Image vor, lässt Sie den Entrypoint überschreiben und Shared Memory festlegen und hält Shell-basierte Images am Laufen. Images, die früher einen eigenen Wrapper brauchten, laufen jetzt so, wie sie sind. Mehr von Ihrer vorhandenen Software lässt sich beim ersten Versuch deployen.

    08

    Wählen Sie Ihre Festplattengröße

    Wählen Sie die Speichergröße für jede Cloud-Maschine, die Sie bereitstellen, auf AWS, Azure und Kinesis Cloud. Große Modelle und Datensätze passen ohne Umwege. Sie zahlen für den Speicher, den Sie brauchen, nicht für einen festen Standardwert.

  10. Februar 2026

    01git push02Build03Livemaina1f3c9eAdd chat endpointKein Dockerfile nötigRepository wird geklontStack wird erkanntImage wird gebautImage wird gepushtLäuftEndpointhttps://my-api…Automatisches Deployment bei PushJeder Push auf Ihren Branch wird automatisch ausgeliefert

    01

    Direkt aus GitHub bereitstellen

    Verbinden Sie ein GitHub-Repository, wählen Sie einen Branch, und Kinesis baut und stellt es für Sie bereit. Kein Docker-Image nötig, mit Live-Build-Logs und einem Deployment-Verlauf. Jeder Push auf Ihren Branch löst automatisch einen neuen Build und ein neues Deployment aus, sodass Sie CI/CD erhalten, ohne eine Pipeline zu schreiben.

    acme/my-apiapp/main.pyrequirements.txt.python-versionREADME.mdKein DockerfileDetected: Python 3.12Dockerfile1FROM python:3.12-slim AS builder2WORKDIR /app3COPY . .4# keep secrets out of the image5RUN rm -rf .git .env .venv67FROM python:3.12-slim8WORKDIR /app9COPY --from=builder /app /app10RUN pip install --no-cache-dir -r requirements.txt11EXPOSE 800012CMD ["uvicorn", "main:app", "--host", "0.0.Dockerfile wird generiert...Live-Streaming

    02

    KI schreibt Ihr Dockerfile

    Kein Dockerfile in Ihrem Repo? Kinesis erkennt, was Ihr Projekt braucht, und eine KI schreibt das Dockerfile für Sie, live gestreamt, während es entsteht. Das beseitigt die häufigste Hürde für Teams, die neu bei Containern sind. Mehr von Ihrem Code erreicht die Produktion, mit weniger DevOps-Wissen.

    my-apibenötigt eine MaschineKein manuelles AufweckenSchläft im Leerlauf, wacht bei Bedarf aufRuhezustandIm Leerlauf, spart GeldWird aufgeweckt...Startet von selbstLäuftBedient die App

    03

    Aufwecken bei Bedarf

    Maschinen im Ruhezustand wachen jetzt automatisch auf, wenn eine App sie braucht. Sie sparen durch den Ruhezustand, ohne Maschinen von Hand wieder einschalten zu müssen. Die Rechenleistung ist da, wenn Ihr Workload sie anfordert, und schläft, wenn nicht.

    04

    Ein frisches, schnelleres Portal

    Ein neues visuelles Design und neu gestaltete Projekt- und App-Seiten zeigen den Status auf einen Blick, mit integrierter Projektsuche. Teams mit vielen Apps finden schneller, was sie brauchen. Die tägliche Verwaltung erfordert weniger Klicks.

    05

    Sorgenfreies Auto-Reload

    Die automatische Aufladung schützt sich jetzt selbst: Nach wiederholt fehlgeschlagenen Kartenbelastungen schaltet sie sich ab und informiert Sie, statt es endlos erneut zu versuchen. Kunden geraten nie in eine Schleife fehlgeschlagener Zahlungen. Die Abrechnung bleibt planbar und transparent.

    06

    Mehr Regionen, mehr GPU-Angebot

    Kinesis Cloud hat neue Rechenzentrumspartner hinzugefügt, mit Speicher, der automatisch an die Maschinen angebunden wird. Kunden erhalten mehr Standorte und mehr GPU-Optionen zur Auswahl. Mehr Angebot bedeutet bessere Verfügbarkeit und bessere Preise.

    07

    Dauerhafte Build-Logs

    Jeder GitHub-Build behält jetzt sein vollständiges Log, sodass Sie es während des Builds und noch lange danach lesen können. Wenn ein Build fehlschlägt, ist der Grund nur einen Klick entfernt. Teams beheben fehlerhafte Builds in Minuten, statt sie erneut auszuführen, um herauszufinden, was passiert ist.

  11. Januar 2026

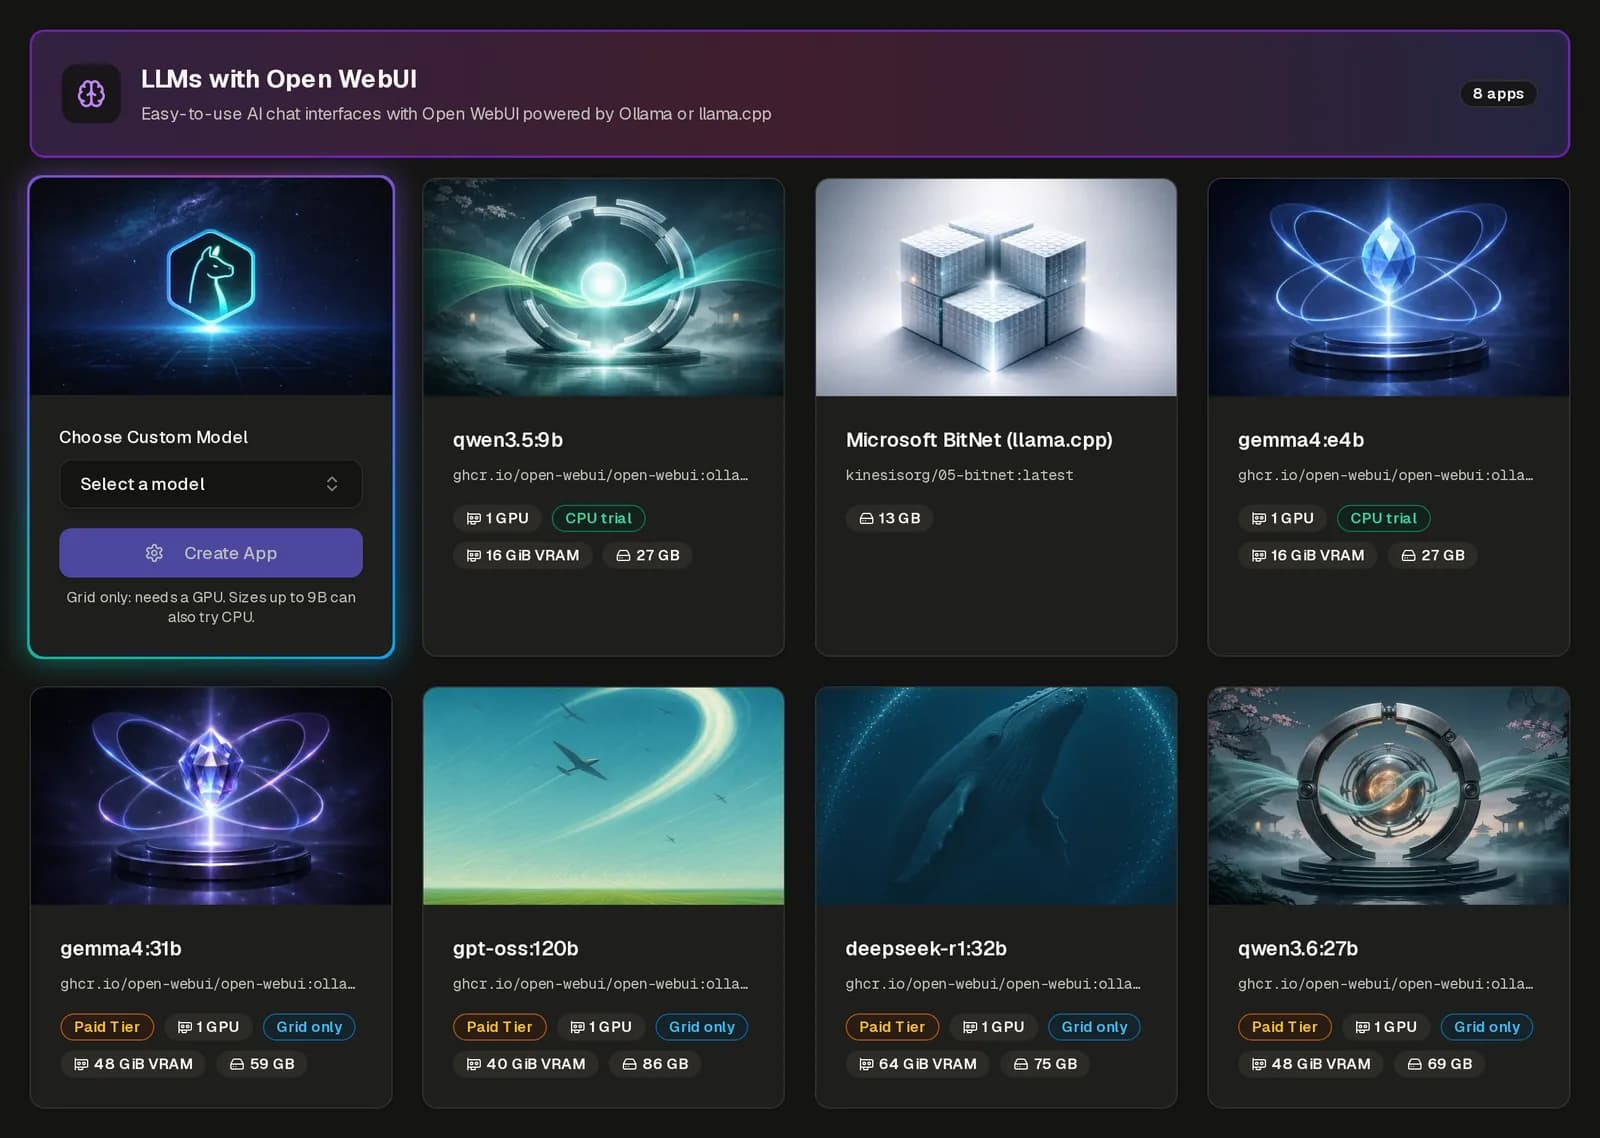
    Die Kinesis App Gallery: LLM-Vorlagen mit Modellauswahl, GPU- und VRAM-Kennzeichnungen

    01

    KI-Modelle mit einem Klick, ohne Konto

    Jeder kann jetzt die Kinesis App-Galerie durchsuchen, bevor er sich registriert, und mit einem Klick genau das Ollama-Modell auswählen, das laufen soll. Teams sehen, was sie ausführen können, bevor sie sich auf irgendetwas festlegen. Von „Ich will dieses Modell ausprobieren“ bis zum laufenden Endpoint dauert es Minuten, nicht ein Wochenende voller Setup.

    VORHERAbgeschlossene Jobsstartete immer wieder neuRestart: AlwaysAusführenErneutErneutErneut…NeustartVerschwendete Rechenleistung, trotzdem berechnetabgerechnetJETZTTask CompletionLäuft einmal, dann stoppt esAusführenAbgeschlossenStoppenabgerechnetArbeit erledigt, Abrechnung stoppt

    02

    Jobs, die bis zum Abschluss laufen

    Mit der neuen Neustart-Richtlinie „Task Completion“ laufen Batch-Jobs, Datenpipelines und einmalige Aufgaben genau einmal und stoppen sauber, wenn sie fertig sind. Bisher konnte ein abgeschlossener Job immer wieder neu starten, was Rechenleistung verschwendete. Jetzt zahlen Sie für die Arbeit, und der Job stoppt, wenn die Arbeit erledigt ist.

    Dedizierte GPU-MaschineEin typischer Tag, Stunde für StundeIntelligenter LebenszyklusRuhezustandApps laufen · abgerechnetRuhezustandGespeichertGespeichert00:0006:0012:0018:0024:00Letzte App stoppt, Maschine geht in den Ruhezustand

    03

    Automatischer Ruhezustand: Schluss mit Kosten für ungenutzte Maschinen

    Dedizierte Maschinen ohne laufende Apps wechseln jetzt von selbst in den Ruhezustand. Kunden zahlen nicht mehr für GPUs, die über Nacht oder zwischen Projekten ungenutzt bleiben. Die Maschine bleibt Ihre und ist bereit, wenn Sie sie wieder brauchen.

    04

    Jede App in Sekunden kopieren

    Exportieren Sie die Konfiguration einer App, importieren Sie sie in eine neue App, oder duplizieren Sie eine bestehende mit einem Klick. Ein Setup von Staging in die Produktion zu übernehmen oder mit einem Teammitglied zu teilen, heißt nicht mehr, es Feld für Feld neu aufzubauen. Die exportierte Datei listet sogar alle zulässigen Werte auf, sodass Änderungen einfach und sicher sind.

    05

    Intelligentere Umgebungsvariablen

    Umgebungsvariablen unterstützen jetzt Platzhalter, die Kinesis für Sie ausfüllt, etwa die eigene Domain Ihrer App, sowie einen schnelleren Massenbearbeitungsmodus. Sie konfigurieren eine App einmal, und sie bleibt korrekt, wenn sich ihre Adresse ändert. Weniger manuelle Änderungen bedeuten weniger fehlerhafte Deployments.

    06

    Load Balancing auf Produktionsniveau

    Apps hinter dem Kinesis-Load-Balancer können jetzt gRPC über TLS bereitstellen, und Web-Apps halten jeden Besucher per Sticky Sessions auf derselben Instanz. Moderne APIs und zustandsbehaftete Web-Apps skalieren ohne Codeänderungen. Ihre Nutzer erhalten eine schnelle, konsistente Erfahrung, egal wie viele Instanzen Sie betreiben.

    07

    Image-Prüfungen vor dem Deployment

    Das Portal prüft Ihr Docker-Image jetzt vor dem Start und bemisst den Speicher anhand des Images selbst. Fehler zeigen sich im Formular, nicht als fehlgeschlagenes Deployment. Weniger Überraschungen und weniger Zeit mit dem Lesen von Fehlerlogs.