
Aller au contenu
Kinesis

Journal des modifications · 2026

Ce que nous avons livré en 2026.

Les fonctionnalités et améliorations destinées aux clients que nous avons publiées chaque mois, de janvier à Novembre, des plus importantes aux moins importantes.

Versions
78
Mois
11
  1. Novembre 2026Jusqu’ici

    01

    Un débogueur IA qui lit votre code

    Déboguer avec l’IA peut désormais lire le dépôt GitHub de votre application au commit exact dont le build a échoué ou qui tourne actuellement, et affiche chaque fichier qu’il lit. Il trouve la cause d’un build cassé dans votre Dockerfile, vos fichiers de paquets ou votre configuration, au lieu de vous demander de les coller. Corriger un déploiement échoué tient en une seule conversation, et seules les personnes autorisées à modifier l’application obtiennent l’accès au dépôt.
  2. Octobre 2026

    AAcme IncProjets · Applications · Grids · FacturationMembres+ Inviter un membreAalice@acme.devAdminPropriétaireBbob@acme.devDéveloppeurCcarol@acme.devDéveloppeurDdave@acme.devLecteurGridsRechercheresearch-gpuProduitproduct-inferenceUne vue unique sur chaque division

    01

    Organisations

    Les comptes d’équipe sont là : projets, applications, Grids, serveurs et facturation appartiennent à votre organisation, avec membres, rôles, invitations et journal d’audit. Chaque division peut gérer ses propres Grids tandis que l’IT garde une vue unique sur l’ensemble. L’arrivée et le départ d’un membre se règlent en quelques secondes.

    La carte de connexion du portail avec Continuer avec l’authentification unique

    02

    Authentification unique (SSO) pour les entreprises

    Les organisations peuvent activer le SSO avec leur fournisseur d’identité, vérifier leurs domaines et exiger le SSO pour chaque membre. Votre équipe se connecte comme elle le fait déjà au travail. Les accès sont contrôlés de manière centralisée et retirés automatiquement quand quelqu’un part.

    Annulez une mauvaise version sans reconstructionDéploiementsStatutSourceDémarréRéussiÉchec du déploiementAdd response cachee4c91a7 mainil y a 5 minRéussiTune batch sizeb7e21d4 mainil y a 2 hRestaurerRéussiAdd chat endpointa1f3c9e mainhierRestaurerRevenu à b7e21d4Même image, redéployée instantanémentPas de reconstructionActif

    03

    Restauration en un clic

    Restaurez instantanément une application déployée depuis GitHub vers n’importe quel build antérieur, sans reconstruction. Une mauvaise version est annulée en quelques secondes. Livrez plus vite, car les erreurs se corrigent à moindre coût.

    GRIDml-researchLes limites s’appliquent en direct aux applications en cours d’exécutionPolitiquesQuotas2 GPU par personne · 15 min de grâceActivéLimites des conteneurs4 cœurs CPU, 16 GiB de mémoire par conteneurActivéRécupération des GPU inactifsÉviction après 30 min d’inactivité · avertissement 10 min avantActivéPartage équitableSessions de 2 h · 1 application par personneActivé

    04

    Contrôle des règles de Grid

    Une page Grid repensée présente toutes les règles d’un coup d’œil : limites de GPU, délais de grâce, plafonds par conteneur, récupération des ressources inactives et partage équitable. Les limites s’appliquent en direct aux conteneurs en cours d’exécution. Les propriétaires définissent les règles une fois, et Kinesis les fait respecter.

    05

    Des Grids qui suivent vos applications

    Lancez une application sur une Grid avant l’arrivée de ses machines : elle démarre dès que des machines adaptées la rejoignent. Les machines Spot ne sont louées que tant qu’une application en cours d’exécution en a besoin, et une nouvelle vue « Applications sur cette Grid » indique quelles applications conviennent à quelles machines. Les propriétaires ne paient plus pour des GPU qu’aucune application n’utilise, et les équipes ne se retrouvent jamais bloquées.

    06

    Voyez qui utilise quoi

    Les pages Serveurs et Grids repensées affichent le matériel de chaque machine, l’utilisation CPU et GPU en direct, les applications qui y tournent et la personne qui l’a ajoutée, avec un résumé de l’ensemble du parc en haut. Les deux pages se chargent en quelques millisecondes, même pour de grands parcs, et conservent une piste d’audit complète. L’IT obtient une visibilité claire sur toute l’organisation, et la planification de la capacité comme les discussions sur les coûts partent de faits.

    07

    Montez jusqu’à 10 000 réplicas, en toute sécurité

    Les applications peuvent désormais exécuter jusqu’à 10 000 réplicas, contre 20 auparavant, pour les gros traitements par lots et les services à fort trafic. Un nouveau groupe de répartition place les applications portant le même nom de groupe sur des machines différentes : la panne d’une machine n’emporte jamais toutes les copies d’une base de données ou d’un cache. Les équipes passent à l’échelle sans renoncer à la résilience.

    08

    Des mises à jour d’applications plus fluides

    Les mises à jour récupèrent désormais la nouvelle image avant d’arrêter l’ancien conteneur, et chaque application peut définir son propre délai de grâce à l’arrêt. L’onglet Déploiements affiche un nouveau build comme En cours de déploiement jusqu’à ce que vos serveurs l’exécutent réellement : Actif signifie donc toujours en production. Les mises à jour entraînent moins d’interruptions, et les équipes savent toujours quel build est servi.

    09

    Ne payez que lorsque les machines louées sont actives

    Les machines Spot louées sur la place de marché ne sont plus facturées pendant qu’elles sont hors ligne. Quand une machine louée disparaît, la Grid la libère et en loue une nouvelle : les applications continuent de tourner. Les clients ne paient que le calcul qu’ils peuvent réellement utiliser.

    10

    Une sécurité renforcée sur toute la plateforme

    Chaque appel d’API interne vérifie désormais le rôle de l’appelant, les serveurs vérifient l’identité du plan de contrôle avant de se connecter, et les clés des machines sont créées sur la machine elle-même. Ces changements ferment des catégories entières d’attaques avant que quiconque puisse les tenter. Les clients bénéficient d’une protection renforcée sans rien changer.

  3. Septembre 2026

    Terminal$ export KINESIS_API_KEY=kn_7Hq2xK9p…$ curl -X POST \https://api.kinesis.network/v1/projects/$PROJECT/apps/$APP/start \-H "Authorization: Bearer $KINESIS_API_KEY"202 Accepted{ "id": "66f2a9c4…", "targetState": "running" }CLÉ APIci-deploykn_7Hq2xK9p…1 projet · 2 autorisationsapps:writecompute:spendDOCUMENTÉOpenAPI 3.1 specapi.kinesis.network/openapi.jsonApplicationsGridsServeurs

    01

    API REST publique et clés API

    Tout ce que vous faites dans le portail peut désormais être automatisé via une API REST documentée (spécification OpenAPI incluse) avec des clés API sécurisées. Branchez Kinesis sur votre CI/CD, vos outils internes et vos scripts. L’infrastructure as code, sans l’infrastructure.

    Assistant IAmcp.kinesis.networkDéploie vLLM sur ma Grid ml-research, 1 GPUAIcreate_appOutil Kinesisname: "llm-chat"image: "vllm/vllm-openai"gpuCount: 1get_app_statusen coursC’est fait. llm-chat est en ligne sur ml-research.GRIDml-researchgpu-node-1llm-chat1 GPUgpu-node-3

    02

    Laissez les agents IA déployer pour vous (MCP)

    Kinesis dispose désormais d’un serveur MCP avec connexion OAuth sécurisée, pour que les assistants et agents IA puissent déployer et gérer vos applications, Grids et builds. Demandez à votre assistant de livrer un modèle, et il s’en charge. C’est le chemin le plus court entre l’idée et une application d’IA en production.

    GRIDml-researchLimiter les GPU par personne4alice@acme.dev2 of 4 GPUsbob@acme.dev4 of 4 GPUs+1carol@acme.dev1 of 4 GPUsDémarrage impossible — quota de GPU de la Grid atteintVotre quota sur ml-research : 4 GPU utilisés sur 4.L’application attend qu’une place se libère.

    03

    Quotas par utilisateur sur les Grids partagées

    Les propriétaires de Grid peuvent plafonner le nombre d’applications, d’instances et de GPU que chaque utilisateur peut prendre. Les utilisateurs voient des avis clairs lorsqu’ils atteignent une limite. La capacité partagée reste équitable et prévisible pour chaque équipe.

    DOMICILE OU BUREAUlab-serverPare-feu / NATLes connexions entrantes restent ferméesTunnel sortantTrafic des applicationsKinesisRemote ReachVos utilisateursAucune redirection de port entrant nécessaire

    04

    Connectez n’importe quelle machine, derrière n’importe quel pare-feu

    L’ajout d’un serveur commence désormais par l’endroit où il est connecté, et la bonne méthode vous est recommandée, y compris Kinesis Remote Reach pour les machines derrière un pare-feu ou un NAT. Inutile d’ouvrir des ports entrants. Les PC de bureau, les laboratoires et les serveurs sur site rejoignent la Grid en quelques minutes, en toute sécurité.

    05

    Sécurité d’exécution intégrée

    Les serveurs cloud exécutent désormais par défaut un moniteur de sécurité qui détecte les activités suspectes des conteneurs, les bloque et vous les signale. Les menaces sont repérées au moment où elles surviennent, pas après les dégâts. La tranquillité d’esprit est fournie de série.

    06

    Modèles d’applications prêts à l’emploi

    Créez une nouvelle application à partir d’un modèle qui a déjà la bonne image, les bons ports et les bonnes ressources. Les charges de travail courantes sont mises en ligne sans lire aucune documentation. Les nouveaux utilisateurs arrivent plus vite à leur première application en marche.

    07

    Comprendre pourquoi une application ne tourne pas

    Les pages des applications, des serveurs et des logs affichent désormais au même endroit les vérifications de placement, les ordres de travail et l’état de la Grid. Lorsqu’une application attend une machine, vous voyez exactement quelle règle la retient. Les problèmes qui nécessitaient un ticket de support se règlent désormais d’un coup d’œil.

    08

    Transformez vos PC Windows en capacité pour la Grid

    Spark, l’application de bureau Kinesis pour Windows, associe désormais un PC à votre compte en quelques clics et vous permet de le mettre en pause ou de définir un planning. Les PC de bureau et de laboratoire apportent de la puissance de calcul pendant les heures où ils resteraient inutilisés. Les propriétaires gardent la main sur les moments où leur machine travaille.

    09

    Les secrets restent secrets

    Kinesis signale désormais les variables d’environnement qui ressemblent à des secrets et masque leurs valeurs dans les listes et les API. Mots de passe et clés API ne fuient plus via des captures d’écran ou des partages d’écran. Les bonnes pratiques de sécurité deviennent la norme.

    10

    Plus de GPU sur la Marketplace

    Les Spot Instances incluent désormais les cartes GeForce RTX série 20 et plus récentes ainsi que les GPU RTX de station de travail, désignés par leur nom de modèle complet. Les clients ont plus de choix, à davantage de niveaux de prix. Les petites charges de travail trouvent du matériel abordable et adapté.

  4. Août 2026

    Redéployez l’application. Les données restent.my-appv1RemplacéeRedéployermy-appv2En coursmêmes volumesStockage persistantjusqu’à 4 par applicationNomChemin de montageTaillemodels/models200 GBdonnées conservéesdb/var/lib/postgresql50 GBdonnées conservéesuploads/data/uploads20 GBdonnées conservées

    01

    Volumes persistants

    Les applications de Grid peuvent désormais conserver jusqu’à 4 volumes de stockage persistants qui survivent aux redémarrages et aux redéploiements. Les bases de données, les caches de modèles et les fichiers envoyés par les utilisateurs restent en sécurité. Les charges de travail avec état tournent désormais sur Kinesis aussi facilement que les charges sans état.

    Un GPU, sept slices isoléesDisposition des GPUGPU 0 — A100 80GB80 GB VRAMMIGNombre max.Divise par deuxMixteCalcul 7/7 · Mémoire 7/81g.10gb#0chat1g.10gb#1embed1g.10gb#2ocr1g.10gb#3rerank1g.10gb#4whisper1g.10gb#5vision1g.10gb#6notebookChaque application dispose de sa propre part de calcul et de mémoire

    02

    Partitionnement des GPU avec MIG

    Divisez les GPU de centre de données (classe A100 et H100) en slices isolées grâce à un concepteur visuel, et attribuez à chaque application sa propre slice. Un seul GPU puissant peut désormais servir en toute sécurité de nombreuses charges de travail plus petites. Faites plus avec moins de matériel.

    Les GPU inactifs reviennent aux applications qui en ont besoinUtilisation du GPU 0notebook-atrain-bseuil d’inactivité!AvertiRécupéréeFenêtre d’inactivitéDélai de grâcenotebook-aInactif sur le GPUretirée de cette GridGPU 0train-bEn coursattendait un GPU

    03

    Récupération des GPU inactifs

    Les Grids peuvent désormais récupérer les GPU des applications inactives, avec des seuils configurables et un avertissement clair avant tout arrêt. Les GPU rares reviennent aux personnes qui les utilisent réellement. Chaque GPU que vous payez fait un vrai travail.

    Quand la Grid est pleine, les utilisateurs passent à tour de rôleOrdre d’arrivéeFile d’attente équitableAUser Aapp-1AUser Aapp-2AUser Aapp-3BUser Bapp-1CUser Capp-1AUser Aapp-11BUser Bapp-12CUser Capp-13AUser Aapp-24AUser Aapp-35GridPleinprochaine machine libreSessions de 2 h · 1 application par personne

    04

    Ordonnancement équitable

    Quand une Grid est pleine, les applications attendent désormais dans une file équitable et passent à tour de rôle, au lieu du principe premier arrivé, premier servi. Aucun utilisateur ne peut accaparer la capacité partagée. Chaque équipe obtient sa part, automatiquement.

    05

    Des super-pouvoirs pour les admins de Grid

    Partagez des Grids avec les rôles Éditeur et Utilisateur, suivez en direct l’utilisation CPU, RAM, GPU et VRAM de chaque application, et arrêtez ou redémarrez les applications depuis un seul écran. Les propriétaires de Grid bénéficient d’une visibilité et d’un contrôle complets sur la capacité partagée. L’IT garde la main sans gêner personne.

    06

    Des réveils qui attendent le stock

    Si un GPU est en rupture de stock au réveil d’une machine en hibernation, Kinesis continue d’essayer et vous indique l’état, et les propriétaires reçoivent une alerte si une machine ne parvient pas à passer en hibernation. Rien ne reste bloqué en silence. Vous pouvez compter sur l’hibernation pour faire des économies sans risquer votre capacité.

    07

    Une galerie d’applications adaptée à la Grid

    L’App Gallery déploie désormais par défaut sur votre Grid lorsque vous en avez une. Modèles et applications arrivent sur le matériel que vous payez déjà, sans configuration supplémentaire. Tirer parti de votre propre calcul ne demande qu’un clic.

  5. Juillet 2026

    Vos machinesBYOC · sans coût supplémentaireInstances dédiéesAWS · Azure · KinesisSpot InstancesPlace de marché KinesisGRIDml-research8 en lignegpu-box-1gpu-box-2train-1train-2train-3spot-1spot-2spot-3

    01

    Grids et Spot Instances

    Les Grids réunissent désormais dans un seul pool vos propres machines, des machines cloud à la demande et des Spot Instances louées sur la marketplace Kinesis. Augmentez ou réduisez votre puissance de calcul en quelques minutes, au prix adapté à chaque charge de travail. Une plateforme, une vue, pour tous les types de calcul que vous utilisez.

    Clés SSH+ Ajouter une cléMon ordinateur portableSHA256:q3Fv8tXbW2…9kXwAdded Jul 8 · assigned to 3 serversgpu-box-1train-1train-2Runner CISHA256:Lm4cR0aZp7…Qe1dAdded Jul 14 · assigned to 1 servertrain-1Terminal$ ssh -i ~/.ssh/id_ed25519ubuntu@203.0.113.24Welcome to Ubuntu 24.04 LTSLast login: Tue Jul 15ubuntu@train-1:~$

    02

    Utilisez vos propres clés SSH

    Téléversez vos clés SSH une seule fois et attribuez-les à vos machines cloud et BYOC pour un accès direct. Les ingénieurs accèdent à leurs machines avec les outils qu’ils utilisent déjà. Vos clés, votre contrôle.

    Applicationllm-servePriorité de la Grid1ml-research2burst-poolGRIDml-researchPrioriser les machines1gpu-box-1Préféréllm-serve2gpu-box-2Normal3spot-1Sauvegarde uniquementDébordementGRIDburst-pool

    03

    Placez vos charges de travail exactement où vous le souhaitez

    Classez les machines par priorité au sein d’une Grid, et laissez une application tourner sur plusieurs Grids. Votre matériel préféré prend le travail en premier, et le reste du parc absorbe le surplus. Un placement plus intelligent, c’est de meilleures performances et des coûts réduits.

    04

    Plusieurs domaines par application

    Une application peut désormais servir plusieurs domaines personnalisés, y compris des domaines racines (apex) comme yourcompany.com. Gérez des sites régionaux, des déclinaisons de marque ou des migrations depuis un seul déploiement. Chaque domaine bénéficie d’un SSL automatique.

    05

    Provider Hub : gagnez de l’argent avec votre matériel

    Les fournisseurs approuvés peuvent proposer des machines entières sur la marketplace Kinesis et suivre leurs gains dans le nouveau Provider Hub. Le matériel qui resterait inutilisé est désormais rentabilisé. Plus d’offre sur le réseau, c’est aussi plus de choix pour tous ceux qui louent.

    06

    GPU A100 à la demande

    Les GPU A100 de data center peuvent désormais être provisionnés directement depuis la page Grids. Les gros travaux d’entraînement et d’inférence disposent de matériel haut de gamme en quelques minutes, sans contrat à long terme. Vous montez en puissance pour le gros chantier et rendez les ressources une fois terminé.

    07

    Des Grids partagées sans friction de facturation

    Les applications exécutées sur une Grid partagée avec vous utilisent désormais les machines de cette Grid sans frais d’utilisation supplémentaires ni vérification de solde. Le propriétaire de la Grid paie la capacité une seule fois, et chaque équipe l’utilise librement. Partager de la puissance de calcul au sein d’une entreprise est enfin aussi simple que partager un dossier.

  6. Juin 2026

    Échec du build> npm cinpm ERR! code EUSAGEnpm ERR! missingpackage-lock.jsonDéboguer avec l’IAKinesis AIBêtaLogs du build échoué de my-apiPourquoi mon build a-t-il échoué ?npm ci a besoin de package-lock.json, mais leLe Dockerfile ne copie que package.json.Modifications de configuration suggérées- COPY package.json ./+ COPY package*.json ./ RUN npm ciAppliquer les modifications de l’application

    01

    Kinesis AI, votre assistant DevOps intégré

    Un assistant IA est désormais intégré au portail. Il peut lire vos échecs de build et les logs de vos applications, expliquer ce qui s’est mal passé et suggérer des corrections de Dockerfile. L’aide est instantanée, contextuelle et disponible 24 h/24, sans file de tickets.

    ProvisionnementKINESIS · 1x A100Mise en file d’attenteConfiguration du systèmeFinalisationEnregistrement du serveurImpossible d’obtenir la capacitéTentative 3 sur 3Nous n’avons pas pu obtenir de serveur.Réessayez maintenant, ou essayez une autre région.RéessayerIgnorer

    02

    Un provisionnement clair, du début à la fin

    Les machines en cours de provisionnement affichent désormais leur progression en direct, les détails de l’instance et des options Réessayer ou Ignorer en cas d’échec. Vous savez toujours ce qui se passe et quoi faire ensuite. Plus besoin de deviner si la capacité arrive.

    ÉTAT DE L’APPLICATIONTéléchargementDémarrageEn coursDémarrage bloquéDémarrage impossible — aucun nœud adaptéAucun nœud ne répond actuellement aux exigences de cette application.gpu-box-1— not enough GPU memoryedge-node-2— not enough GPUs

    03

    Des états d’application plus clairs

    Les applications affichent désormais des états précis au fil de leurs changements, dont un nouvel état « Démarrage bloqué » qui explique pourquoi une application ne peut pas démarrer. Les petites modifications d’une application en cours d’exécution ne sont plus bloquées sans raison. Moins de confusion, des corrections plus rapides.

    04

    Stockage SSD local rapide, sans frais supplémentaires

    Les machines cloud peuvent désormais utiliser un SSD local rapide pour les images et les conteneurs, et le stockage d’instance intégré n’est plus facturé séparément. Les gros modèles se chargent plus vite et les coûts baissent. De meilleures performances pour moins cher.

    05

    « Ne jamais hiberner » pour les machines critiques

    Épinglez n’importe quelle machine pour qu’elle ne se mette jamais automatiquement en veille prolongée. Les services permanents restent prêts, tandis que le reste de votre parc continue de faire des économies. Économies et fiabilité, machine par machine.

    06

    Une couche de trafic auto-réparatrice

    Le trafic vers vos applications passe désormais par une couche App Proxy reconstruite qui vérifie sa propre santé et répare automatiquement routes et certificats. Vos points de terminaison restent disponibles même quand une partie du réseau traverse une mauvaise passe. La fiabilité s’améliore sans aucun changement de votre côté.

    07

    Gérez facilement de grands parcs

    Une nouvelle vue en liste pour les Grids et les serveurs ajoute la recherche, la pagination et une vue par application. Les équipes qui gèrent des centaines de machines trouvent celle qu’il leur faut en quelques secondes. Le portail évolue avec votre parc.

  7. Mai 2026

    Partager le projetChoisissez qui peut ouvrir ml-research.dana@acme.devDéveloppeurEnvoyer l’invitationAJOUTÉBbob@acme.devDéveloppeurCcarol@acme.devLecteur1alice@acme.devvous a ajouté au projet"ml-research"Dans l’application et par e-mail

    01

    Partagez projets et applications avec votre équipe

    Invitez des collaborateurs sur n’importe quel projet ou application avec le bon rôle, et tenez tout le monde informé grâce aux notifications dans l’application et par e-mail. Les équipes travaillent ensemble au même endroit au lieu de partager des identifiants. Les accès sont clairs, et vous pouvez les retirer à tout moment.

    Authentification à deux facteursSaisissez le code à 6 chiffres de votreapplication d’authentification.48291Se souvenir de ce navigateur pendant 30 joursVérifierOUUtiliser une passkeyTouch ID, Windows Helloou une clé de sécuritéUtiliser un code de secours••••-••••••••-••••••••-••••••••-••••

    02

    Authentification à deux facteurs et passkeys

    Protégez votre compte avec une application d’authentification ou une passkey/clé de sécurité, avec codes de secours et appareils de confiance. Vos charges de travail et votre facturation restent protégées même si un mot de passe fuite. Une sécurité de niveau entreprise qui s’active en quelques secondes.

    SourceGitHubDockerHubLien DockerTéléverserTARmy-model.tarTéléversement... 64 %docker save -o my-model.tar my-modelTéléversement terminémy-model.tarCréer une applicationEn coursAucun registre nécessaire

    03

    Déploiement par upload

    Téléversez un fichier d’image Docker directement sur Kinesis et déployez-le. Aucun registre nécessaire. Builds en environnement isolé, modèles privés et équipes sans registre peuvent désormais livrer en un seul téléversement.

    04

    Intégration de serveurs avec un seul jeton

    Apportez votre propre puissance de calcul avec une seule commande d’installation et un jeton personnel que vous pouvez régénérer à tout moment. Ajouter un serveur prend une minute, et l’accès reste sous votre contrôle. Passer d’une machine à cent est aussi simple que d’exécuter une commande.

    05

    Historique d’activité complet

    Chaque projet et chaque application disposent désormais d’un historique d’activité qui indique qui a modifié quoi, et quand. Les équipes retracent n’importe quelle modification en quelques secondes. Les audits et les post-mortems deviennent simples.

    06

    Une facturation prête pour l’entreprise

    Payez par carte, virement ou ACH, recevez des factures qui détaillent chaque machine et téléchargez toutes vos charges et tous vos crédits au format CSV. Les équipes financières obtiennent les documents dont elles ont besoin sans passer par le support. Kinesis s’adapte désormais à la façon dont achètent les grandes entreprises.

    07

    Les journaux de chaque instance, côte à côte

    Diffusez les journaux de plusieurs instances d’une application à la fois, dans des onglets que vous organisez vous-même. Les problèmes qui n’apparaissent que sur une seule machine sont faciles à repérer. Déboguer des applications réparties ne veut plus dire passer d’une page à l’autre.

  8. Avril 2026

    Ajouter des serveurs1× H100 80GBGPU · 26 vCPUsFORTE DEMANDE1× A100 80GBGPU · 28 vCPUs1× L40S 48GBGPU · 16 vCPUsRejoindre la file d’attente pour une instance disponibleENSUITEEn file d’attentePas besoin d’actualiserAcquisautomatiquementPrévenir par e-mail quandc’est prêt

    01

    Stock en direct et précommande

    Consultez la disponibilité GPU et CPU en direct avant de provisionner, avec des étiquettes « forte demande ». Quand une machine est en rupture de stock, vous pouvez quand même la commander : Kinesis l’obtient pour vous dès qu’elle se libère. Plus besoin d’actualiser les pages pour attraper un GPU disponible.

    my-appSourceDurée d’exécutionRéseauMode d’exécutionRessourcesModèle d’exécutionServiceAPI, inférenceendpointsTâchesExécuter jusqu’àachèvementPlanifiéPlanning fixeBientôt disponibleRessourcesCalculNouvelle GridUtiliser une Grid existanteServerless

    02

    Une façon plus simple de configurer les applications

    La configuration des applications dispose désormais d’onglets clairs pour la stratégie d’exécution et de calcul, avec des choix sous forme de cartes. Vous décrivez comment votre application doit fonctionner, et Kinesis se charge des détails matériels. Les nouveaux utilisateurs arrivent plus vite à un déploiement fonctionnel, et les experts gardent un contrôle total.

    AUTONOMIE≈ 12 joursd’exécution restant sur votre soldeE-mailProtégeraujourd’hui48h2hProtection en cas de solde faibleSeuil d’hibernation2 heuresEnviron 48 h d’exécution restantessur votre soldePuis à 24 h, 12 h et 1 h,avant que votre solde ne soit épuisé

    03

    Autonomie prépayée et protection des nœuds

    Voyez combien de temps votre solde fera tourner vos machines, protégez les machines critiques contre l’arrêt automatique et recevez des alertes par e-mail suffisamment tôt. Fini les interruptions surprises dues à un solde trop bas. Anticiper devient simple.

    04

    Machines auto-réparatrices

    Les machines victimes d’une panne critique redémarrent et se rétablissent désormais seules, et vous pouvez remplacer une machine défectueuse par une neuve en un clic. Vos applications sont moins souvent hors service, et votre équipe passe moins de temps sur le support. La fiabilité, sans surveillance permanente.

    05

    Un contrôle total de vos logs

    Choisissez la durée de conservation des logs, téléchargez-les ou supprimez-les, parcourez l’historique et consultez les logs système d’une machine depuis le portail. Le débogage prend quelques minutes au lieu de sessions SSH. Vous décidez de la quantité de données que vous conservez, pour vos coûts comme pour votre conformité.

    06

    Les modèles ouverts les plus récents, prêts à tourner

    L’App Gallery accueille les derniers modèles ouverts, dont Gemma 4, Qwen 3.5 et Qwen 3.6. Les équipes testent les nouveaux modèles dès la semaine de leur sortie, en un clic. Rester à jour avec l’IA open source ne demande aucun effort d’ingénierie supplémentaire.

    07

    Les registres privés en toute simplicité

    Déployez depuis des registres Docker privés avec des identifiants que Kinesis vérifie avant d’enregistrer vos modifications. Un mot de passe erroné s’affiche dans le formulaire, pas sous la forme d’une application cassée. Les images privées deviennent aussi faciles à livrer que les images publiques.

  9. Mars 2026

    Calcul dédiéFournisseur cloudAWSAzureKinesisGPUCPUType d’instanceg5.xlarge1× A10G GPURégionUS East (N. Virginia)Gridml-researchVotre machineBYOCVotre machineBYOCg5.xlargeAWSA rejointVos machines + le cloud, une seule Grid

    01

    Lancer des machines cloud depuis le Portail

    Les Grids provisionnent désormais à la demande des machines cloud AWS, Azure et Kinesis, directement depuis le portail, avec les options GPU et CPU côte à côte. Plus de comptes cloud ni de consoles séparés à gérer. Votre propre matériel et la capacité cloud à la demande sont réunis au même endroit.

    https://app.yourcompany.comYYourCompanyDNS vérifiéEnregistrement trouvéCertificat émisSSL géré pour vousRenouvellement automatiquePas de mauvaise surprise à l’expiration

    02

    Votre domaine, SSL automatique

    Associez votre propre domaine à n’importe quelle application, et Kinesis émet et gère le certificat SSL pour vous. Vos utilisateurs voient votre marque, pas la nôtre. Plus jamais de corvée de certificats.

    Achetez des GPU une fois, partagez-les avec toutes les équipesAdmin ITPropriétaireAchète la capacité une seule foisGridgpu-gridGPU 1ABGPU 2CAGPU 3BGPU 4CBÉquipe APartagé · exécute des applicationsÉquipe BPartagé · exécute des applicationsÉquipe CPartagé · exécute des applications

    03

    Grids partagées

    Les propriétaires de Grid peuvent désormais partager leurs machines avec d’autres utilisateurs et équipes. Un administrateur IT peut acheter de la capacité une seule fois et y donner accès à toutes les équipes. Les GPU coûteux servent à tous ceux qui en ont besoin, au lieu d’être verrouillés sur un seul compte.

    04

    Hibernation, réveil et redémarrage selon vos conditions

    Mettez les machines en veille, réveillez-les ou redémarrez-les en un clic, avec un statut clair à chaque étape. Vous décidez quand économiser et quand avoir de la capacité prête. Des commandes simples vous laissent aux commandes, sans SSH ni scripts.

    05

    Une seule facture pour tout votre calcul

    Les machines dédiées affichent désormais leur prix d’emblée, s’intègrent à une vue d’ensemble des coûts du parc et figurent sur les mêmes factures que tout le reste. Les équipes financières voient une seule facture claire au lieu de plusieurs. Vous savez toujours ce que coûte votre parc avant l’arrivée de la facture.

    06

    Ne faites jamais tourner une image obsolète

    Kinesis détecte désormais lorsqu’un tag Docker pointe vers une nouvelle image et propose de récupérer la dernière version. Vous savez toujours si votre application exécute le code que vous venez de pousser. Fini les redéploiements qui conservent discrètement l’ancien build.

    07

    Configuration de conteneur plus intelligente

    Le formulaire d’application suggère désormais les ports à partir de votre image, vous permet de remplacer son entrypoint et de définir la mémoire partagée, et maintient en marche les images basées sur un shell. Les images qui nécessitaient un wrapper personnalisé tournent désormais telles quelles. Une plus grande partie de vos logiciels existants se déploie du premier coup.

    08

    Choisissez la taille de votre disque

    Choisissez la taille de stockage de chaque machine cloud que vous provisionnez, sur AWS, Azure et Kinesis cloud. Les grands modèles et jeux de données tiennent sans bricolage. Vous payez le disque dont vous avez besoin, pas une taille fixe par défaut.

  10. Février 2026

    01git push02Build03En directmaina1f3c9eAdd chat endpointAucun Dockerfile nécessaireClonage du dépôtDétection de la stackConstruction de l’imageEnvoi de l’imageEn coursEndpointhttps://my-api…Déploiement automatique à chaque pushChaque push sur votre branche se livre tout seul

    01

    Déployez directement depuis GitHub

    Connectez un dépôt GitHub, choisissez une branche, et Kinesis le construit et le déploie pour vous. Aucune image Docker nécessaire, avec les logs de build en direct et un historique des déploiements. Chaque push sur votre branche reconstruit et redéploie automatiquement : vous obtenez du CI/CD sans écrire de pipeline.

    acme/my-apiapp/main.pyrequirements.txt.python-versionREADME.mdPas de DockerfileDetected: Python 3.12Dockerfile1FROM python:3.12-slim AS builder2WORKDIR /app3COPY . .4# keep secrets out of the image5RUN rm -rf .git .env .venv67FROM python:3.12-slim8WORKDIR /app9COPY --from=builder /app /app10RUN pip install --no-cache-dir -r requirements.txt11EXPOSE 800012CMD ["uvicorn", "main:app", "--host", "0.0.Génération du Dockerfile...diffusion en direct

    02

    L’IA écrit votre Dockerfile

    Pas de Dockerfile dans votre dépôt ? Kinesis détecte ce dont votre projet a besoin et une IA rédige le Dockerfile pour vous, en le diffusant en direct au fil de l’écriture. Cela lève l’obstacle le plus courant pour les équipes qui découvrent les conteneurs. Davantage de votre code atteint la production, avec moins de connaissances DevOps nécessaires.

    my-apia besoin d’une machinePas de réveil manuelEn veille quand inactif, prêt quand il le fautEn hibernationInactif, économies en coursRéveil...Démarre tout seulEn coursDiffusion de l’application

    03

    Réveil à la demande

    Les machines en hibernation se réveillent désormais automatiquement lorsqu’une application en a besoin. Vous profitez des économies de l’hibernation sans la corvée de rallumer les machines à la main. La puissance de calcul est là quand votre charge de travail la demande, et en veille quand elle n’en a pas besoin.

    04

    Un portail repensé et plus rapide

    Un nouveau thème visuel et des pages Projets et Applications repensées affichent l’état d’un coup d’œil, avec une recherche de projets intégrée. Les équipes qui ont de nombreuses applications trouvent plus vite ce qu’elles cherchent. La gestion au quotidien demande moins de clics.

    05

    Rechargement automatique sans souci

    La recharge automatique se protège désormais elle-même : après plusieurs échecs de débit de la carte, elle se désactive et vous prévient au lieu de boucler. Les clients ne restent jamais bloqués dans un cycle de paiements échoués. La facturation reste prévisible et transparente.

    06

    Plus de régions, plus de GPU disponibles

    Kinesis Cloud a ajouté de nouveaux centres de données partenaires, avec un stockage rattaché automatiquement aux machines. Les clients disposent de plus d’emplacements et de plus d’options GPU. Plus d’offre, c’est une meilleure disponibilité et de meilleurs prix.

    07

    Journaux de build persistants

    Chaque build GitHub conserve désormais son log complet, que vous pouvez lire pendant le build et longtemps après. Quand un build échoue, la raison est à un clic. Les équipes corrigent les builds cassés en quelques minutes au lieu de les relancer pour comprendre ce qui s’est passé.

  11. Janvier 2026

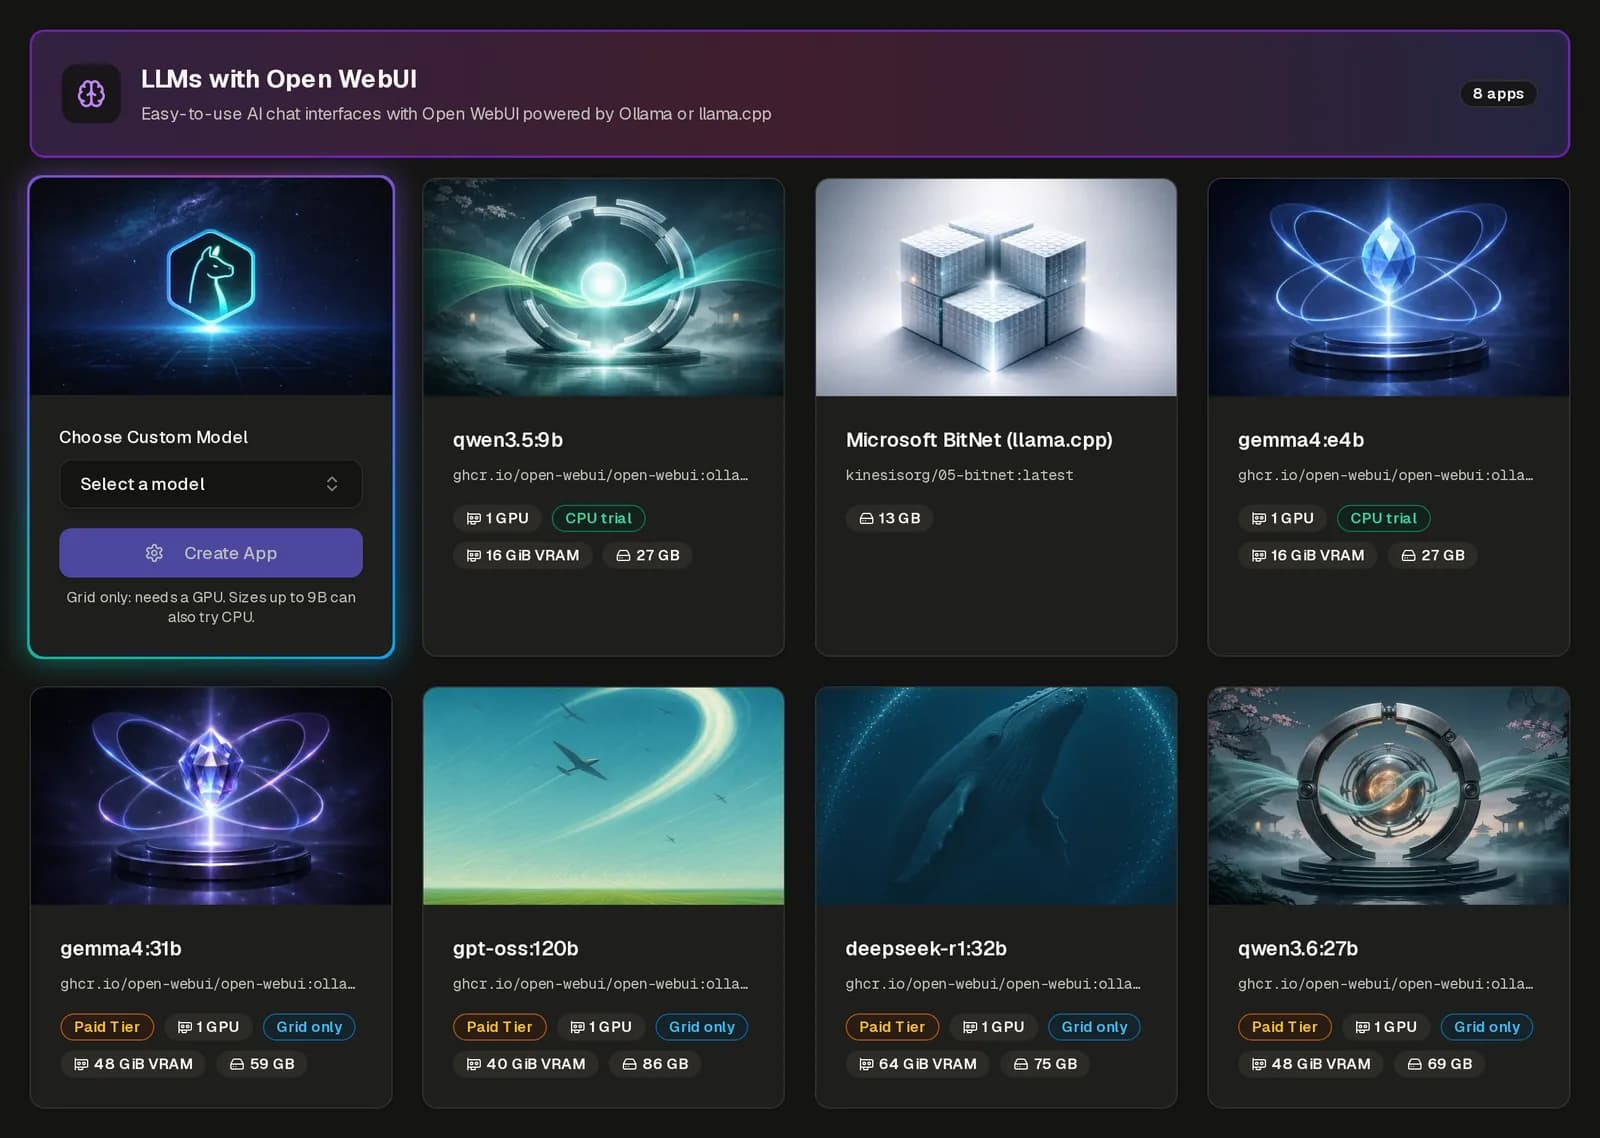
    L’App Gallery de Kinesis : modèles de LLM avec sélecteur de modèle, badges GPU et VRAM

    01

    Modèles d’IA en un clic, sans compte

    Tout le monde peut désormais parcourir la galerie d’applications Kinesis avant de s’inscrire, et choisir en un clic le modèle Ollama exact à exécuter. Les équipes voient ce qu’elles peuvent exécuter avant de s’engager. Passer de « J’ai envie d’essayer ce modèle » à un endpoint opérationnel prend quelques minutes, pas un week-end de configuration.

    AVANTTâches terminéesredémarrait en boucleRestart: AlwaysExécuterEncoreEncoreEncore…redémarrageCalcul gaspillé, mais toujours facturéfacturéMAINTENANTTask CompletionS’exécute une fois, puis s’arrêteExécuterTerminéArrêterfacturéTravail terminé, facturation arrêtée

    02

    Tâches exécutées jusqu’à leur terme

    La nouvelle politique de redémarrage « Task Completion » permet aux tâches par lots, aux pipelines de données et aux tâches ponctuelles de s’exécuter une fois et de s’arrêter proprement à la fin. Auparavant, une tâche terminée pouvait redémarrer encore et encore, gaspillant du calcul. Désormais, vous payez pour le travail, et la tâche s’arrête quand il est terminé.

    Machine GPU dédiéeUne journée type, heure par heureCycle de vie intelligentEn hibernationApplications en cours · facturéesEn hibernationEnregistréEnregistré00:0006:0012:0018:0024:00Dernière application arrêtée, la machine se met en veille prolongée

    03

    Hibernation automatique : ne payez plus pour des machines inactives

    Les machines dédiées sans application en cours d’exécution passent désormais d’elles-mêmes en hibernation. Les clients ne paient plus pour des GPU inactifs la nuit ou entre deux projets. La machine reste la vôtre, prête à reprendre du service dès que vous en avez besoin.

    04

    Copiez n’importe quelle application en quelques secondes

    Exportez la configuration d’une application, importez-la dans une nouvelle application ou dupliquez une application existante en un clic. Faire passer une configuration de la préproduction à la production, ou la partager avec un coéquipier, ne veut plus dire la reconstruire champ par champ. Le fichier exporté liste même toutes les valeurs autorisées : les modifications sont faciles et sûres.

    05

    Des variables d’environnement plus intelligentes

    Les variables d’environnement prennent désormais en charge des espaces réservés que Kinesis remplit pour vous, comme le domaine de votre application, ainsi qu’un mode d’édition groupée plus rapide. Vous configurez une application une fois, et elle reste correcte quand son adresse change. Moins de modifications manuelles, c’est moins de déploiements cassés.

    06

    Équilibrage de charge de niveau production

    Les applications derrière le load balancer de Kinesis peuvent désormais servir du gRPC sur TLS, et les applications web maintiennent chaque visiteur sur la même instance grâce aux sessions persistantes. Les API modernes et les applications web avec état passent à l’échelle sans modification du code. Vos utilisateurs bénéficient d’une expérience rapide et cohérente, quel que soit le nombre d’instances que vous exécutez.

    07

    Vérification des images avant déploiement

    Le portail valide désormais votre image Docker avant le lancement et dimensionne le stockage à partir de l’image elle-même. Les erreurs apparaissent dans le formulaire, et non sous forme de déploiement en échec. Moins de surprises, et moins de temps passé à lire des journaux d’erreurs.