
Vai al contenuto
Kinesis

Changelog · 2026

Cosa abbiamo rilasciato nel 2026.

Le funzionalità e i miglioramenti per i clienti che abbiamo rilasciato ogni mese, da gennaio a Novembre, a partire dai più importanti.

Release
78
Mesi
11
  1. Novembre 2026Finora

    01

    Un debugger AI che legge il tuo codice

    Debug con AI ora può leggere il repository GitHub della tua app esattamente al commit la cui build non è riuscita o che è in esecuzione adesso, e mostra ogni file che legge. Trova la causa di una build non riuscita nel Dockerfile, nei file dei pacchetti o nella configurazione, invece di chiederti di incollarli. Correggere un deploy non riuscito richiede una sola chat, e solo chi può modificare l'app ottiene l'accesso al repository.
  2. Ottobre 2026

    AAcme IncProgetti · App · Grid · FatturazioneMembri+ Invita membroAalice@acme.devAdminProprietarioBbob@acme.devDeveloperCcarol@acme.devDeveloperDdave@acme.devViewerGridRicercaresearch-gpuProdottoproduct-inferenceUn'unica vista su ogni divisione

    01

    Organizzazioni

    Gli account team sono arrivati: progetti, app, Grid, server e fatturazione appartengono alla tua organizzazione, con membri, ruoli, inviti e un registro di audit. Ogni divisione può gestire le proprie Grid mentre l'IT mantiene un'unica vista su tutto. Onboarding e offboarding richiedono pochi secondi.

    La scheda di accesso al portale con Continua con Single Sign-On

    02

    Single sign-on aziendale

    Le organizzazioni possono attivare l'SSO con il proprio identity provider, verificare i propri domini e richiedere l'SSO a ogni membro. Il tuo team accede come fa già al lavoro. L'accesso è controllato centralmente e revocato automaticamente quando qualcuno lascia l'azienda.

    Annulla una release difettosa senza ricostruireDeploymentStatoFonteAvviatoCompletatoDeploy non riuscitoAdd response cachee4c91a7 main5 min faCompletatoTune batch sizeb7e21d4 main2 h faEsegui il rollbackCompletatoAdd chat endpointa1f3c9e mainieriEsegui il rollbackTornato a b7e21d4Stessa immagine, ridistribuita all'istanteNessuna ricostruzioneAttivo

    03

    Rollback con un clic

    Riporta istantaneamente un'app distribuita da GitHub a qualsiasi build precedente, senza ricostruirla. Una release difettosa si annulla in pochi secondi. Rilasci più velocemente, perché correggere gli errori costa poco.

    GRIDml-researchI limiti si applicano in tempo reale alle app in esecuzionePolicyQuote2 GPU a persona · 15 min di tolleranzaOnLimiti dei container4 core CPU, 16 GiB di memoria per containerOnRecupero delle GPU inattiveRimozione dopo 30 min di inattività · avviso 10 min primaOnFair shareTurni di 2 h · 1 app a personaOn

    04

    Controlli delle policy del Grid

    Una pagina del Grid ridisegnata mostra ogni policy a colpo d'occhio: limiti di GPU, periodi di tolleranza, limiti per container, recupero delle risorse inattive e fair share. I limiti vengono applicati in tempo reale ai container in esecuzione. I proprietari impostano le regole una volta e Kinesis le fa rispettare.

    05

    Grid che seguono le tue app

    Avvia un'app su una Grid prima che arrivino le sue macchine: partirà non appena si uniscono macchine adatte. Le macchine spot vengono noleggiate solo finché un'app in esecuzione ne ha bisogno, e una nuova vista “App su questa Grid” mostra quali app sono adatte a quali macchine. I proprietari smettono di pagare GPU che nessuna app usa e i team non restano mai bloccati da un limite rigido.

    06

    Scopri chi usa cosa

    Le pagine Server e Grid riprogettate mostrano l'hardware di ogni macchina, l'utilizzo di CPU e GPU in tempo reale, di chi sono le app che vi girano e chi l'ha aggiunta, con un riepilogo dell'intera flotta in alto. Entrambe le pagine si caricano in millisecondi, anche per flotte di grandi dimensioni, e mantengono un audit trail completo. L'IT ottiene una visibilità chiara su tutta l'organizzazione, e la pianificazione della capacità e le discussioni sui costi partono dai fatti.

    07

    Scala fino a 10.000 repliche, in sicurezza

    Le app ora possono arrivare a 10.000 repliche, rispetto alle 20 di prima, per grandi job batch e servizi ad alto traffico. Un nuovo spread group mantiene le app con lo stesso nome di gruppo su macchine diverse, così il guasto di una macchina non mette mai fuori uso tutte le copie di un database o di una cache. I team scalano senza rinunciare alla resilienza.

    08

    Aggiornamenti delle app più fluidi

    Gli aggiornamenti ora scaricano la nuova immagine prima di fermare il vecchio container, e ogni app può impostare il proprio periodo di tolleranza per lo spegnimento. La scheda Deployments mostra una nuova build come Deploying finché i tuoi server non la eseguono davvero, quindi Active significa sempre live. Gli aggiornamenti causano meno downtime e i team sanno sempre quale build è in servizio.

    09

    Paga solo quando le macchine noleggiate sono attive

    Le macchine spot noleggiate dal marketplace non vengono più fatturate per il tempo in cui sono offline. Quando una macchina noleggiata si spegne, la Grid la rilascia e ne noleggia una nuova, così le app continuano a girare. I clienti pagano solo il calcolo che possono effettivamente usare.

    10

    Sicurezza rafforzata su tutta la piattaforma

    Ogni chiamata API interna ora verifica il ruolo del chiamante, i server verificano l'identità del control plane prima di connettersi e le chiavi delle macchine vengono create sulla macchina stessa. Queste modifiche chiudono intere classi di attacchi prima che qualcuno possa tentarli. I clienti ottengono una protezione più forte senza cambiare nulla.

  3. Settembre 2026

    Terminale$ export KINESIS_API_KEY=kn_7Hq2xK9p…$ curl -X POST \https://api.kinesis.network/v1/projects/$PROJECT/apps/$APP/start \-H "Authorization: Bearer $KINESIS_API_KEY"202 Accepted{ "id": "66f2a9c4…", "targetState": "running" }CHIAVE APIci-deploykn_7Hq2xK9p…1 progetto · 2 permessiapps:writecompute:spendDOCUMENTATOOpenAPI 3.1 specapi.kinesis.network/openapi.jsonAppGridServer

    01

    API REST pubblica e chiavi API

    Tutto ciò che fai nel portale ora si può automatizzare tramite una REST API documentata (specifica OpenAPI inclusa) con chiavi API sicure. Integra Kinesis nella tua CI/CD, negli strumenti interni e negli script. Infrastructure as code, senza l'infrastruttura.

    Assistente AImcp.kinesis.networkFai il deploy di vLLM sul mio Grid ml-research, 1 GPUAIcreate_appStrumento Kinesisname: "llm-chat"image: "vllm/vllm-openai"gpuCount: 1get_app_statusin esecuzioneFatto. llm-chat è attiva su ml-research.GRIDml-researchgpu-node-1llm-chat1 GPUgpu-node-3

    02

    Lascia che siano gli agenti AI a fare il deploy (MCP)

    Kinesis ora ha un server MCP con accesso OAuth sicuro, così assistenti e agenti AI possono distribuire e gestire le tue app, Grid e build. Chiedi al tuo assistente di pubblicare un modello, e lo fa. È la via più breve dall'idea a un'app AI in esecuzione.

    GRIDml-researchLimita le GPU per persona4alice@acme.dev2 of 4 GPUsbob@acme.dev4 of 4 GPUs+1carol@acme.dev1 of 4 GPUsImpossibile avviare: quota GPU del grid raggiuntaLa tua quota su ml-research: 4 GPU su 4 in uso.L'app attende finché non si libera spazio.

    03

    Quote per utente sulle Grid condivise

    I proprietari dei Grid possono limitare quante app, istanze e GPU può usare ciascun utente. Gli utenti ricevono avvisi chiari quando raggiungono un limite. La capacità condivisa resta equa e prevedibile per ogni team.

    CASA O UFFICIOlab-serverFirewall / NATIl traffico in entrata resta chiusoTunnel in uscitaTraffico delle appKinesisRemote ReachI tuoi utentiNessun port forwarding in entrata necessario

    04

    Collega qualsiasi macchina, dietro qualsiasi firewall

    Ora l'aggiunta di un server parte da dove è connesso e consiglia il metodo giusto, incluso Kinesis Remote Reach per le macchine dietro un firewall o un NAT. Non serve aprire porte in ingresso. PC d'ufficio, laboratori e server on-prem si uniscono in pochi minuti, in sicurezza.

    05

    Sicurezza runtime integrata

    I server cloud ora eseguono per impostazione predefinita un monitor di sicurezza che rileva attività sospette nei container, le blocca e te le segnala. Le minacce vengono intercettate mentre si verificano, non dopo il danno. La tranquillità è inclusa di serie.

    06

    Template di app pronti all'uso

    Crea una nuova app da un template che ha già l'immagine, le porte e le risorse giuste. I carichi di lavoro più comuni vanno live senza leggere documentazione. I nuovi utenti arrivano più in fretta alla loro prima app in esecuzione.

    07

    Scopri perché un'app non è in esecuzione

    Le pagine di app, server e log ora mostrano in un unico posto i controlli di allocazione, gli ordini di lavoro e lo stato del Grid. Quando un'app attende una macchina, vedi esattamente quale regola la trattiene. Problemi che prima richiedevano un ticket di assistenza ora si risolvono con un'occhiata.

    08

    Trasforma i PC Windows in capacità per la Grid

    Spark, l'app desktop di Kinesis per Windows, ora collega un PC al tuo account in pochi clic e ti permette di metterlo in pausa o di impostare una programmazione. I PC di uffici e laboratori aggiungono potenza di calcolo nelle ore in cui resterebbero inattivi. I proprietari decidono sempre quando la loro macchina lavora.

    09

    I segreti restano segreti

    Kinesis ora segnala le variabili d'ambiente che sembrano segreti e ne nasconde i valori in elenchi e API. Password e chiavi API non trapelano da screenshot o schermi condivisi. Le best practice di sicurezza diventano lo standard.

    10

    Più GPU sul Marketplace

    Le istanze spot ora includono le schede GeForce RTX serie 20 e successive e le GPU RTX per workstation, indicate con il nome completo del modello. I clienti hanno più scelta a più fasce di prezzo. I carichi di lavoro più piccoli trovano hardware adatto e conveniente.

  4. Agosto 2026

    Fai il redeploy dell'app. I dati restano.my-appv1SostituitaRedeploymy-appv2In esecuzionestessi volumiStorage persistentefino a 4 per appNomePercorso di mountDimensionemodels/models200 GBdati conservatidb/var/lib/postgresql50 GBdati conservatiuploads/data/uploads20 GBdati conservati

    01

    Volumi persistenti

    Le app sul Grid ora possono mantenere fino a 4 volumi di storage persistenti che sopravvivono a riavvii e nuovi deploy. Database, cache dei modelli e file caricati dagli utenti restano al sicuro. I carichi di lavoro con stato ora girano su Kinesis con la stessa facilità di quelli senza stato.

    Una GPU, sette slice isolateLayout delle GPUGPU 0 — A100 80GB80 GB VRAMMIGNumero massimoMetàMistoCalcolo 7/7 · Memoria 7/81g.10gb#0chat1g.10gb#1embed1g.10gb#2ocr1g.10gb#3rerank1g.10gb#4whisper1g.10gb#5vision1g.10gb#6notebookOgni app ha la sua quota di calcolo e di memoria

    02

    Frazionamento delle GPU con MIG

    Suddividi le GPU da data center (classe A100 e H100) in slice isolate con un designer visivo del layout e assegna a ogni app la sua slice. Una sola GPU potente può ora servire in sicurezza molti carichi di lavoro più piccoli. Fai di più con meno hardware.

    Le GPU inattive tornano alle app che ne hanno bisognoUtilizzo GPU 0notebook-atrain-bsoglia di inattività!AvvisataRecuperateFinestra di inattivitàPeriodo di tolleranzanotebook-aInattiva sulla GPUspostata da questa GridGPU 0train-bIn esecuzioneera in attesa di una GPU

    03

    Recupero delle GPU inattive

    I Grid ora possono recuperare le GPU dalle app inattive, con soglie configurabili e un avviso chiaro prima che qualcosa venga fermato. Le GPU scarse tornano a chi le sta usando davvero. Ogni GPU che paghi fa un lavoro reale.

    Quando la Grid è piena, gli utenti fanno a turnoOrdine di arrivoCoda fair shareAUser Aapp-1AUser Aapp-2AUser Aapp-3BUser Bapp-1CUser Capp-1AUser Aapp-11BUser Bapp-12CUser Capp-13AUser Aapp-24AUser Aapp-35GridPienoprossima macchina liberaTurni di 2 h · 1 app a persona

    04

    Scheduling fair share

    Quando una Grid è piena, le app ora attendono in una coda equa e fanno a turno, invece di seguire l'ordine di arrivo. Nessun singolo utente può monopolizzare la capacità condivisa. Ogni team ottiene la sua quota, automaticamente.

    05

    Superpoteri per gli amministratori del Grid

    Condividi le Grid con i ruoli Editor e User, vedi l'utilizzo in tempo reale di CPU, RAM, GPU e VRAM per ogni app e ferma o riavvia le app da un'unica schermata. I proprietari delle Grid hanno piena visibilità e controllo sulla capacità condivisa. L'IT mantiene il comando senza essere d'intralcio.

    06

    Risvegli che attendono la disponibilità

    Se una GPU è esaurita quando una macchina ibernata si riattiva, Kinesis continua a riprovare e ti mostra lo stato, e i proprietari ricevono un avviso se una macchina non riesce ad andare in ibernazione. Niente si blocca in silenzio. Puoi contare sull'ibernazione per risparmiare senza mettere a rischio la tua capacità.

    07

    Una galleria di app integrata con il Grid

    La App Gallery ora fa il deploy sulla tua Grid per impostazione predefinita, se ne hai una. Modelli e app finiscono sull'hardware che già paghi, senza configurazioni aggiuntive. Sfruttare il tuo calcolo richiede un solo clic.

  5. Luglio 2026

    Le tue macchineBYOC · nessun costo aggiuntivoIstanze dedicateAWS · Azure · KinesisSpot InstancesMarketplace KinesisGRIDml-research8 onlinegpu-box-1gpu-box-2train-1train-2train-3spot-1spot-2spot-3

    01

    Grid e Spot Instances

    I Grid ora riuniscono in un unico pool le tue macchine, le macchine cloud on demand e le Spot Instances noleggiate dal marketplace di Kinesis. Aumenta e riduci la potenza di calcolo in pochi minuti, al prezzo adatto a ogni carico di lavoro. Una piattaforma, una vista, per ogni tipo di potenza di calcolo che usi.

    Chiavi SSH+ Aggiungi chiaveIl mio laptopSHA256:q3Fv8tXbW2…9kXwAdded Jul 8 · assigned to 3 serversgpu-box-1train-1train-2Runner CISHA256:Lm4cR0aZp7…Qe1dAdded Jul 14 · assigned to 1 servertrain-1Terminale$ ssh -i ~/.ssh/id_ed25519ubuntu@203.0.113.24Welcome to Ubuntu 24.04 LTSLast login: Tue Jul 15ubuntu@train-1:~$

    02

    Usa le tue chiavi SSH

    Carica le tue chiavi SSH una volta sola e assegnale alle tue macchine cloud e BYOC per l'accesso diretto. Gli ingegneri accedono alle loro macchine con gli strumenti che già usano. Le tue chiavi, il tuo controllo.

    Appllm-servePriorità del Grid1ml-research2burst-poolGRIDml-researchDai priorità alle macchine1gpu-box-1Preferitallm-serve2gpu-box-2Normale3spot-1Solo backupOverflowGRIDburst-pool

    03

    Posiziona i carichi di lavoro esattamente dove vuoi

    Ordina le macchine per priorità all'interno di una Grid e fai girare una stessa app su più Grid. L'hardware che preferisci riceve il lavoro per primo e il resto della flotta è lì per l'overflow. Un posizionamento più intelligente significa prestazioni migliori e costi più bassi.

    04

    Più domini per app

    Un'app può ora servire più domini personalizzati, inclusi i domini root (apex) come yourcompany.com. Gestisci siti regionali, varianti di brand o migrazioni da un unico deployment. Ogni dominio ottiene SSL automatico.

    05

    Provider Hub: guadagna con il tuo hardware

    I fornitori approvati possono mettere in vendita macchine intere sul marketplace di Kinesis e monitorare i propri guadagni nel nuovo Provider Hub. L'hardware che resterebbe inutilizzato ora si ripaga da solo. Più offerta sulla rete significa anche più scelta per chiunque noleggi.

    06

    GPU A100 on demand

    Le GPU A100 da data center si possono ora attivare direttamente dalla pagina Grid. I grandi job di training e inferenza ottengono hardware di fascia alta in pochi minuti, senza contratti a lungo termine. Scali per il grande job e restituisci tutto quando hai finito.

    07

    Grid condivise senza complicazioni di fatturazione

    Le app che girano su un Grid condiviso con te ora usano le macchine di quel Grid senza costi aggiuntivi a consumo né controlli del saldo. Il proprietario del Grid paga la capacità una volta e ogni team la usa liberamente. Condividere potenza di calcolo all'interno di un'azienda è finalmente semplice come condividere una cartella.

  6. Giugno 2026

    Build non riuscita> npm cinpm ERR! code EUSAGEnpm ERR! missingpackage-lock.jsonDebug con AIKinesis AIBetaLog della build non riuscita di my-apiPerché la mia build non è riuscita?npm ci richiede package-lock.json, ma ilIl Dockerfile copia solo package.json.Modifiche alla configurazione suggerite- COPY package.json ./+ COPY package*.json ./ RUN npm ciApplica le modifiche all'app

    01

    Kinesis AI, il tuo assistente DevOps integrato

    Ora nel portale c'è un assistente AI. Può leggere gli errori di build e i log delle app, spiegare cosa è andato storto e suggerire correzioni al Dockerfile. L'aiuto è immediato, contestuale e disponibile 24 ore su 24, senza code di ticket.

    ProvisioningKINESIS · 1x A100In codaConfigurazione del sistemaFinalizzazioneRegistrazione del serverImpossibile raggiungere la capacitàTentativo 3 di 3Non siamo riusciti a ottenere un server.Riprova ora o prova un'altra regione.RiprovaIgnora

    02

    Provisioning chiaro, dall'inizio alla fine

    Le macchine in fase di provisioning ora mostrano l'avanzamento in tempo reale, i dettagli dell'istanza e le opzioni Riprova o Ignora se qualcosa non va. Sai sempre cosa sta succedendo e cosa fare dopo. Basta chiedersi se la capacità sta arrivando.

    STATO DELL'APPDownload in corsoAvvio in corsoIn esecuzioneAvvio bloccatoImpossibile avviare: nessun nodo adattoAl momento nessun nodo soddisfa i requisiti di questa app.gpu-box-1— not enough GPU memoryedge-node-2— not enough GPUs

    03

    Stati delle app più chiari

    Le app ora mostrano stati precisi man mano che cambiano, incluso un nuovo stato “Avvio bloccato” che spiega perché un'app non può avviarsi. Le piccole modifiche a un'app in esecuzione non vengono più bloccate senza motivo. Meno confusione, correzioni più rapide.

    04

    Storage SSD locale veloce, senza costi aggiuntivi

    Le macchine cloud ora possono usare SSD locali veloci per immagini e container, e lo storage di istanza integrato non viene più fatturato a parte. I modelli grandi si caricano più velocemente e i costi scendono. Prestazioni migliori a un costo inferiore.

    05

    “Mai in ibernazione” per le macchine critiche

    Fissa qualsiasi macchina in modo che non vada mai in ibernazione automaticamente. I servizi sempre attivi restano pronti, mentre il resto della flotta continua a farti risparmiare. Ottieni sia risparmio che affidabilità, macchina per macchina.

    06

    Un livello di traffico che si ripara da solo

    Il traffico verso le tue app ora passa attraverso un livello App Proxy ricostruito, che controlla il proprio stato e ripara automaticamente route e certificati. I tuoi endpoint restano attivi anche quando una parte della rete ha una giornata storta. L'affidabilità migliora senza alcuna modifica da parte tua.

    07

    Gestisci grandi flotte con facilità

    Una nuova vista a elenco per Grid e server aggiunge ricerca, paginazione e una vista per singola app. I team con centinaia di macchine trovano quella che cercano in pochi secondi. Il portale cresce con la tua flotta.

  7. Maggio 2026

    Condividi progettoScegli chi può aprire ml-research.dana@acme.devDeveloperInvia invitoAGGIUNTOBbob@acme.devDeveloperCcarol@acme.devViewer1alice@acme.devti ha aggiunto al progetto"ml-research"Nell'app e via email

    01

    Condividi progetti e app con il tuo team

    Invita collaboratori in qualsiasi progetto o app con il ruolo giusto e tieni tutti aggiornati con notifiche nell'app e via email. I team lavorano insieme in un unico posto invece di condividere le credenziali. Gli accessi sono chiari e puoi revocarli in qualsiasi momento.

    Autenticazione a due fattoriInserisci il codice a 6 cifre della tuaapp di autenticazione.48291Ricorda questo browser per 30 giorniVerificaOPPUREUsa una passkeyTouch ID, Windows Helloo una chiave di sicurezzaUsa un codice di backup••••-••••••••-••••••••-••••••••-••••

    02

    Autenticazione a due fattori e passkey

    Proteggi il tuo account con un'app di autenticazione o una passkey/chiave di sicurezza, con codici di backup e dispositivi attendibili. Così i tuoi carichi di lavoro e la tua fatturazione restano al sicuro anche se una password viene divulgata. È una sicurezza di livello enterprise che si attiva in pochi secondi.

    FonteGitHubDockerHubDocker LinkCaricaTARmy-model.tarCaricamento... 64%docker save -o my-model.tar my-modelCaricamento completatomy-model.tarCrea appIn esecuzioneNessun registry necessario

    03

    Deploy tramite upload

    Carica un file immagine Docker direttamente su Kinesis e fai il deploy. Nessun registry necessario. Build air-gapped, modelli privati e team senza registry possono ora rilasciare con un solo upload.

    04

    Onboarding dei server con un solo token

    Porta la tua potenza di calcolo con un solo comando di installazione e un token personale che puoi rigenerare in qualsiasi momento. Aggiungere un server richiede un minuto e l'accesso resta sotto il tuo controllo. Passare da una macchina a cento è semplice come eseguire un comando.

    05

    Cronologia completa delle attività

    Ogni progetto e ogni app ora hanno un registro attività che mostra chi ha modificato cosa e quando. I team possono ricostruire qualsiasi modifica in pochi secondi. Audit e post-mortem diventano semplici.

    06

    Fatturazione pronta per le aziende

    Paga con carta, bonifico o ACH, ricevi fatture che elencano ogni macchina e scarica tutti i tuoi addebiti e crediti in CSV. I team finance ottengono i documenti di cui hanno bisogno senza contattare il supporto. Kinesis ora si adatta al modo in cui acquistano le aziende più grandi.

    07

    I log di ogni istanza, fianco a fianco

    Visualizza in streaming i log di più istanze di un'app contemporaneamente, in schede che organizzi tu. I problemi che si presentano su una sola macchina diventano facili da individuare. Il debug delle app scalate non significa più saltare da una pagina all'altra.

  8. Aprile 2026

    Aggiungi server1× H100 80GBGPU · 26 vCPUsALTA DOMANDA1× A100 80GBGPU · 28 vCPUs1× L40S 48GBGPU · 16 vCPUsMettiti in coda per un'istanza disponibileALLORAIn codaNessun aggiornamento manuale della paginaAcquisitaautomaticamenteEmail quandoè disponibile

    01

    Disponibilità in tempo reale e ordini anticipati

    Vedi la disponibilità di GPU e CPU in tempo reale prima del provisioning, con le etichette “alta domanda”. Quando una macchina è esaurita, puoi ordinarla comunque e Kinesis la ottiene per te non appena si libera. Basta aggiornare le pagine per accaparrarsi una GPU libera.

    my-appFonteDurataReteEsecuzioneRisorseModello di esecuzioneServizioAPI, inferenzaendpointAttivitàEsegui fino acompletamentoPianificatoOrario fissoProssimamenteRisorseCalcoloNuova GridUsa una Grid esistenteServerless

    02

    Un modo più semplice per configurare le app

    La configurazione delle app ora ha schede chiare per Esecuzione e Strategia di calcolo, con scelte a schede. Descrivi come deve girare la tua app e Kinesis gestisce i dettagli hardware. I nuovi utenti arrivano più in fretta a un deploy funzionante e gli esperti mantengono il pieno controllo.

    AUTONOMIA≈ 12 giornidi autonomia residua sul tuo saldoEmailProteggioggi48h2hProtezione saldo bassoSoglia di ibernazione2 oreCirca 48h di esecuzione rimanentisul tuo saldoDi nuovo a 24h, 12h e 1h,prima che il saldo si esaurisca

    03

    Autonomia prepagata e protezione dei nodi

    Scopri per quanto tempo il tuo saldo manterrà in funzione le macchine, proteggi le macchine critiche dallo spegnimento automatico e ricevi avvisi via email in anticipo. Nessun disservizio a sorpresa perché il saldo si è esaurito. Pianificare in anticipo diventa facile.

    04

    Macchine che si riparano da sole

    Le macchine che subiscono un guasto critico ora si riavviano e si ripristinano da sole, e puoi sostituire una macchina difettosa con una nuova con un clic. Le tue app restano ferme meno a lungo e il tuo team dedica meno tempo al supporto. Affidabilità senza doverle sorvegliare.

    05

    Pieno controllo dei tuoi log

    Scegli per quanto tempo conservare i log, scaricali o eliminali, consulta la cronologia e visualizza i log di sistema di una macchina dal portale. Il debug richiede minuti invece di sessioni SSH. Decidi tu quanti dati conservare, per i costi e per la conformità.

    06

    I modelli open più recenti, pronti all'uso

    La App Gallery ha aggiunto i modelli open più recenti, tra cui Gemma 4, Qwen 3.5 e Qwen 3.6. I team provano i nuovi modelli nella settimana stessa in cui escono, con un clic. Restare al passo con l'AI open source non richiede lavoro di ingegneria aggiuntivo.

    07

    Registry privati in tutta semplicità

    Fai il deploy da registry Docker privati con credenziali che Kinesis verifica prima di salvare le modifiche. Una password errata viene segnalata nel modulo, non come un'app guasta. Le immagini private diventano facili da distribuire quanto quelle pubbliche.

  9. Marzo 2026

    Calcolo dedicatoProvider cloudAWSAzureKinesisGPUCPUTipo di istanzag5.xlarge1× A10G GPURegioneUS East (N. Virginia)Gridml-researchLa tua macchinaBYOCLa tua macchinaBYOCg5.xlargeAWSCollegatoLe tue macchine + il cloud, un'unica Grid

    01

    Avvia macchine cloud dal Portale

    I Grid ora attivano macchine cloud AWS, Azure e Kinesis on demand, direttamente dal portale, con opzioni GPU e CPU affiancate. Nessun account cloud o console separati da gestire. Il tuo hardware e la capacità cloud on demand convivono in un unico posto.

    https://app.yourcompany.comYYourCompanyDNS verificatoRecord trovatoCertificato emessoSSL gestito per teRinnovo automaticoNessuna sorpresa alla scadenza

    02

    Il tuo dominio, SSL automatico

    Collega il tuo dominio a qualsiasi app e Kinesis emette e gestisce il certificato SSL per te. I tuoi utenti vedono il tuo brand, non il nostro. Mai più incombenze legate ai certificati.

    Compra le GPU una volta, condividile con ogni teamAmministratore ITProprietarioAcquista la capacità una voltaGridgpu-gridGPU 1ABGPU 2CAGPU 3BGPU 4CBTeam ACondivisa · esegue appTeam BCondivisa · esegue appTeam CCondivisa · esegue app

    03

    Grid condivise

    I proprietari dei Grid ora possono condividere le proprie macchine con altri utenti e team. Un amministratore IT può acquistare capacità una volta e darne accesso a ogni team. Le GPU costose vengono usate da tutti quelli che ne hanno bisogno, invece di restare legate a un solo account.

    04

    Ibernazione, riattivazione e riavvio alle tue condizioni

    Metti in sospensione, risveglia o riavvia le macchine con un clic, con uno stato chiaro a ogni passaggio. Decidi tu quando risparmiare e quando avere capacità pronta. Controlli semplici ti lasciano il comando senza SSH né script.

    05

    Un'unica fattura per tutto il tuo calcolo

    Le macchine dedicate ora mostrano il prezzo in anticipo, confluiscono in una panoramica dei costi della flotta e compaiono nelle stesse fatture di tutto il resto. I team finance vedono una sola fattura chiara invece di tante. Sai sempre quanto costa la tua flotta prima che arrivi la fattura.

    06

    Mai più un'immagine obsoleta

    Kinesis ora rileva quando un tag Docker punta a una nuova immagine e propone di scaricare la versione più recente. Sai sempre se la tua app esegue il codice che hai appena pushato. Basta redeploy che mantengono silenziosamente la vecchia build.

    07

    Configurazione dei container più intelligente

    Il modulo dell'app ora suggerisce le porte a partire dalla tua immagine, ti consente di sovrascriverne l'entrypoint e di impostare la memoria condivisa, e mantiene in esecuzione le immagini basate su shell. Le immagini che prima richiedevano un wrapper personalizzato ora girano così come sono. Più software che già possiedi viene distribuito al primo tentativo.

    08

    Scegli la dimensione del disco

    Scegli la dimensione dello storage per ogni macchina cloud di cui fai il provisioning, su AWS, Azure e Kinesis cloud. Modelli e dataset di grandi dimensioni ci stanno senza stratagemmi. Paghi il disco che ti serve, non una dimensione predefinita fissa.

  10. Febbraio 2026

    01git push02Build03Livemaina1f3c9eAdd chat endpointNessun Dockerfile necessarioClonazione del repositoryRilevamento dello stackCreazione dell'immaginePush dell'immagine in corsoIn esecuzioneEndpointhttps://my-api…Deploy automatico al pushOgni push sul tuo branch va in produzione da solo

    01

    Deploy diretto da GitHub

    Collega un repository GitHub, scegli un branch e Kinesis ne fa la build e il deploy per te. Non serve un'immagine Docker, con log di build in tempo reale e una cronologia dei deployment. Ogni push sul tuo branch ricompila e ridistribuisce automaticamente, così hai CI/CD senza scrivere una pipeline.

    acme/my-apiapp/main.pyrequirements.txt.python-versionREADME.mdNessun DockerfileDetected: Python 3.12Dockerfile1FROM python:3.12-slim AS builder2WORKDIR /app3COPY . .4# keep secrets out of the image5RUN rm -rf .git .env .venv67FROM python:3.12-slim8WORKDIR /app9COPY --from=builder /app /app10RUN pip install --no-cache-dir -r requirements.txt11EXPOSE 800012CMD ["uvicorn", "main:app", "--host", "0.0.Generazione del Dockerfile...in streaming live

    02

    L'AI scrive il tuo Dockerfile

    Non hai un Dockerfile nel tuo repo? Kinesis rileva ciò di cui il tuo progetto ha bisogno e un'AI scrive il Dockerfile per te, mostrandolo in streaming mentre lo genera. Questo elimina l'ostacolo più comune per i team alle prime armi con i container. Più codice arriva in produzione, con meno competenze DevOps necessarie.

    my-apiserve una macchinaNessun risveglio manualeIn pausa quando è inattivo, operativo quando serveIbernataInattiva, risparmio in corsoRisveglio in corso...Si avvia da solaIn esecuzioneApp in servizio

    03

    Risveglio on demand

    Le macchine ibernate ora si riattivano automaticamente quando un'app ne ha bisogno. Ottieni i risparmi dell'ibernazione senza il fastidio di riaccendere le macchine a mano. La potenza di calcolo c'è quando il tuo carico di lavoro la richiede, e dorme quando non serve.

    04

    Un portale rinnovato e più veloce

    Un nuovo tema grafico e le pagine Progetti e App ridisegnate mostrano lo stato a colpo d'occhio, con la ricerca dei progetti integrata. I team con molte app trovano più in fretta ciò che cercano. La gestione quotidiana richiede meno clic.

    05

    Ricarica automatica senza pensieri

    La ricarica automatica ora si protegge da sola: dopo ripetuti addebiti sulla carta non riusciti, si disattiva e te lo segnala invece di riprovare all'infinito. I clienti non restano mai bloccati in un ciclo di pagamenti falliti. La fatturazione resta prevedibile e trasparente.

    06

    Più regioni, più offerta di GPU

    Kinesis Cloud ha aggiunto nuovi partner data center, con storage collegato automaticamente alle macchine. I clienti hanno più località e più opzioni GPU tra cui scegliere. Più offerta significa migliore disponibilità e prezzi migliori.

    07

    Log di build persistenti

    Ogni build da GitHub ora conserva il log completo, così puoi leggerlo durante la build e anche molto tempo dopo. Quando una build non riesce, il motivo è a un clic di distanza. I team correggono le build non riuscite in pochi minuti invece di rieseguirle per capire cosa è successo.

  11. Gennaio 2026

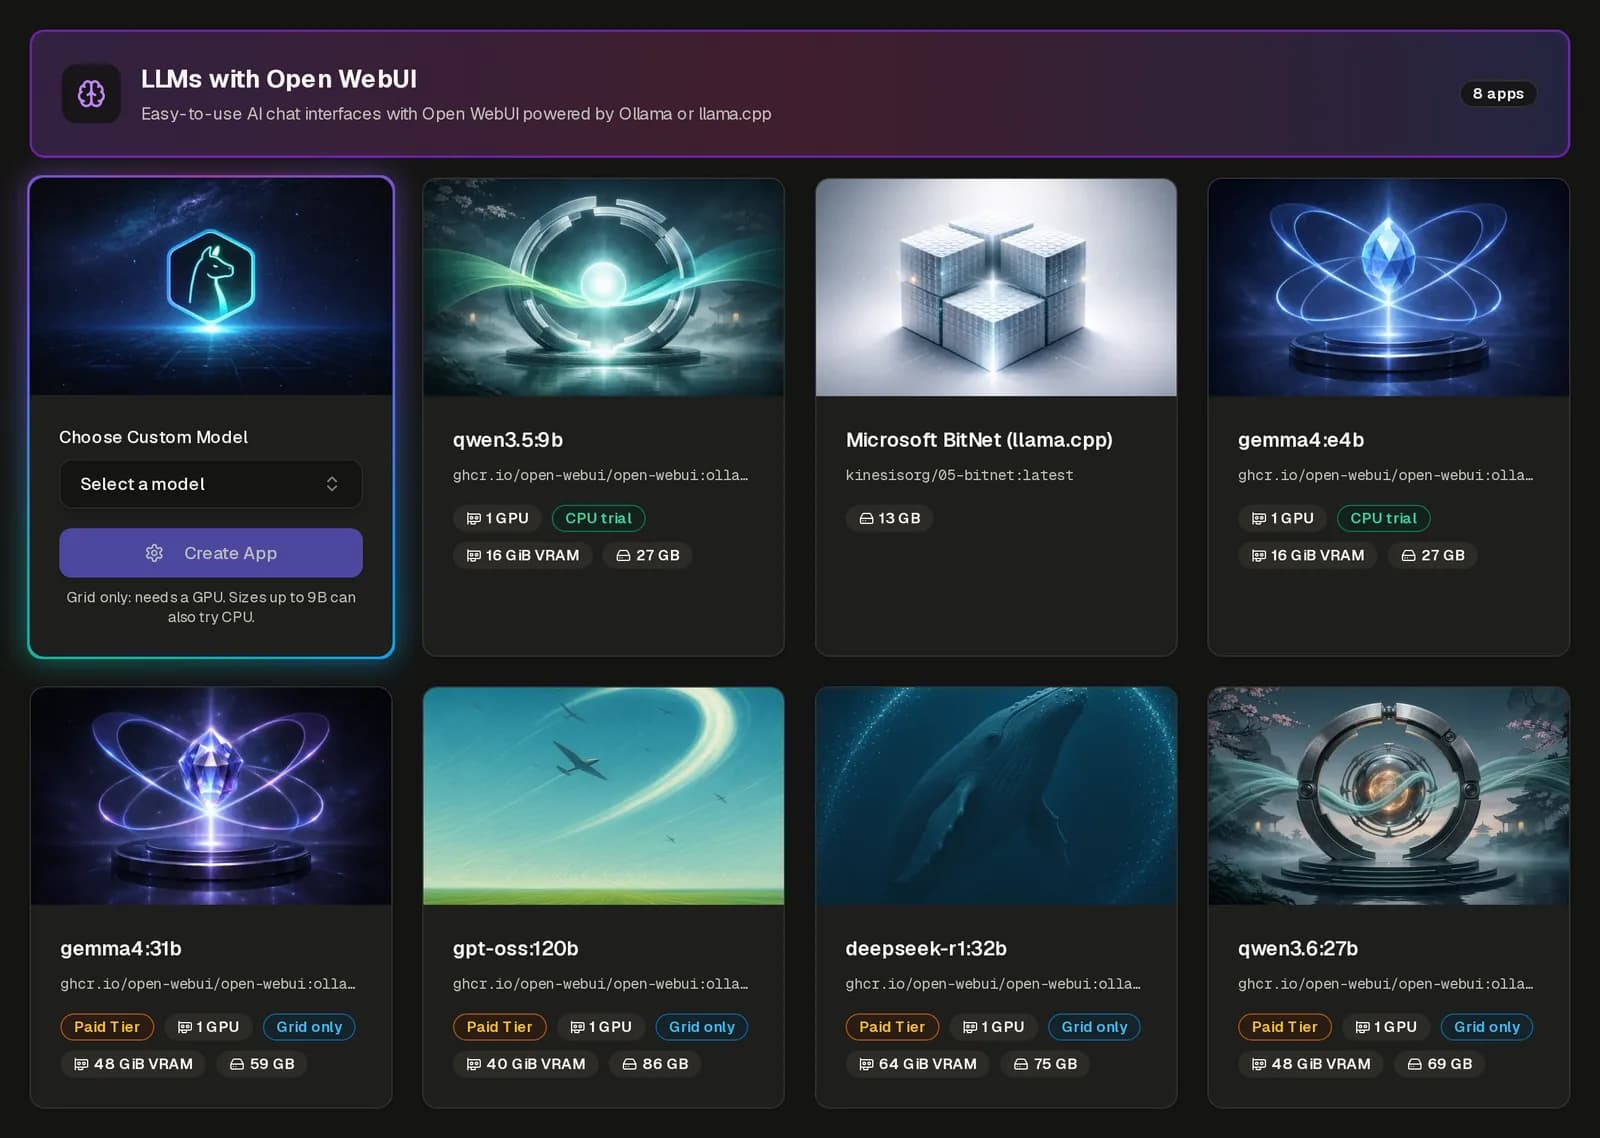
    La App Gallery di Kinesis: template LLM con selettore di modello e badge di GPU e VRAM

    01

    Modelli AI con un clic, senza bisogno di account

    Ora chiunque può esplorare la App Gallery di Kinesis prima di registrarsi e scegliere con un clic il modello Ollama esatto da eseguire. I team vedono cosa possono eseguire prima di impegnarsi in qualsiasi cosa. Passare da “voglio provare questo modello” a un endpoint funzionante richiede minuti, non un weekend di configurazione.

    PRIMAJob completaticontinuava a riavviarsiRestart: AlwaysEseguiDi nuovoDi nuovoDi nuovo…riavvioCalcolo sprecato, ma comunque fatturatofatturatoORATask CompletionViene eseguito una volta, poi si fermaEseguiCompletatoFermafatturatoLavoro finito, fatturazione ferma

    02

    Job eseguiti fino al completamento

    La nuova policy di riavvio “Task Completion” consente a job batch, pipeline di dati e attività una tantum di essere eseguiti una sola volta e di fermarsi in modo pulito al termine. Prima, un job finito poteva riavviarsi più e più volte, sprecando calcolo. Ora paghi per il lavoro, e il job si ferma quando il lavoro è finito.

    Macchina GPU dedicataUna giornata tipo, ora per oraCiclo di vita intelligenteIbernataApp in esecuzione · fatturateIbernataSalvatoSalvato00:0006:0012:0018:0024:00L'ultima app si ferma, la macchina va in ibernazione

    03

    Ibernazione automatica: smetti di pagare le macchine inattive

    Le macchine dedicate senza app in esecuzione ora vanno in ibernazione da sole. I clienti non pagano più GPU che restano inattive di notte o tra un progetto e l'altro. La macchina resta tua, pronta a ripartire quando ti serve.

    04

    Copia qualsiasi app in pochi secondi

    Esporta la configurazione di un'app, importala in una nuova app o duplica un'app esistente con un clic. Spostare una configurazione dallo staging alla produzione, o condividerla con un collega, non significa più ricostruirla campo per campo. Il file esportato elenca persino tutti i valori consentiti, così le modifiche sono facili e sicure.

    05

    Variabili d'ambiente più intelligenti

    Le variabili d'ambiente ora supportano segnaposto che Kinesis compila per te, come il dominio della tua app, oltre a una modalità di modifica in blocco più veloce. Configuri un'app una volta e resta corretta anche quando il suo indirizzo cambia. Meno modifiche manuali significano meno deploy non riusciti.

    06

    Bilanciamento del carico di livello production

    Le app dietro il load balancer di Kinesis ora possono servire gRPC su TLS, e le web app mantengono ogni visitatore sulla stessa istanza grazie alle sticky session. Le API moderne e le web app con stato scalano senza modifiche al codice. I tuoi utenti hanno un'esperienza veloce e coerente, indipendentemente da quante istanze esegui.

    07

    Controlli sull'immagine prima del deploy

    Il portale ora convalida la tua immagine Docker prima del lancio e dimensiona lo storage in base all'immagine stessa. Gli errori emergono nel modulo, non come deploy falliti. Meno sorprese e meno tempo passato a leggere log di errore.