01
コードを読む AI デバッガー
「AI でデバッグ」が、ビルドに失敗したコミットや現在実行中のコミットの時点で、アプリの GitHub リポジトリを読めるようになりました。読み込んだファイルも一つひとつ表示されます。ファイルを貼り付けてもらう代わりに、Dockerfile、パッケージファイル、設定からビルド失敗の原因を突き止めます。失敗したデプロイの修正はチャット1回で完了し、リポジトリにアクセスできるのはアプリを編集できるユーザーだけです。


変更履歴 · 2026
1 月から 11月 まで、毎月リリースしたお客様向けの機能と改善を、重要度の高い順にご紹介します。
01
「AI でデバッグ」が、ビルドに失敗したコミットや現在実行中のコミットの時点で、アプリの GitHub リポジトリを読めるようになりました。読み込んだファイルも一つひとつ表示されます。ファイルを貼り付けてもらう代わりに、Dockerfile、パッケージファイル、設定からビルド失敗の原因を突き止めます。失敗したデプロイの修正はチャット1回で完了し、リポジトリにアクセスできるのはアプリを編集できるユーザーだけです。
01
チームアカウントが登場しました。プロジェクト、アプリ、Grid、サーバー、請求が組織に帰属し、メンバー、ロール、招待、監査ログを備えています。各部門が独自の Grid を運用しながら、IT 部門はすべてを 1 つのビューで把握できます。オンボーディングもオフボーディングも数秒で完了します。
02
組織は、自社の ID プロバイダーで SSO を有効にし、ドメインを検証して、すべてのメンバーに SSO を必須にできます。チームは職場でいつも使っている方法でサインインできます。アクセスは一元管理され、退職者のアクセスは自動で削除されます。
03
GitHub からデプロイしたアプリを、再ビルドなしで以前の任意のビルドに即座にロールバックできます。問題のあるリリースも数秒で元に戻せます。ミスを低コストで直せるので、より速くリリースできます。
04
再設計された Grid ページでは、GPU 上限、猶予期間、コンテナごとの上限、アイドル回収、フェアシェアなど、すべてのポリシーがひと目でわかります。上限は実行中のコンテナにリアルタイムで適用されます。オーナーがルールを一度設定すれば、あとは Kinesis が適用します。
05
マシンが届く前に Grid でアプリを起動しておけば、条件に合うマシンが参加した時点で開始されます。Spot マシンは、実行中のアプリが必要とする間だけリースされます。また、新しい「この Grid のアプリ」ビューで、どのアプリがどのマシンに適合するかを確認できます。オーナーはどのアプリも使っていない GPU に料金を払わずに済み、チームが厳しい制限で足止めされることもありません。
06
刷新されたサーバーページと Grid ページでは、各マシンのハードウェア、CPU と GPU のリアルタイム使用率、そこで動いているアプリの所有者、マシンを追加した人を確認でき、上部にはフリート全体のサマリーが表示されます。どちらのページも大規模なフリートでもミリ秒単位で読み込まれ、完全な監査証跡を保持します。IT 部門は組織全体を明確に見渡せるようになり、キャパシティ計画やコストの議論を事実から始められます。
07
大規模なバッチジョブや高トラフィックのサービス向けに、アプリのレプリカ数の上限が 20 から 10,000 に引き上げられました。新しいスプレッドグループにより、同じグループ名を持つアプリは別々のマシンに配置されるため、マシンが1台ダウンしてもデータベースやキャッシュのコピーがすべて失われることはありません。チームは耐障害性を犠牲にすることなくスケールアウトできます。
08
更新時には、古いコンテナを停止する前に新しいイメージを取得するようになり、アプリごとにシャットダウンの猶予期間を設定できます。デプロイメントタブでは、新しいビルドがサーバーで実際に動き始めるまで「デプロイ中」と表示されるため、「アクティブ」は常に稼働中を意味します。更新によるダウンタイムが減り、チームはどのビルドが提供されているかを常に把握できます。
09
マーケットプレイスからリースした Spot マシンは、オフラインの時間に課金されなくなりました。リース中のマシンが応答しなくなると、Grid はそのマシンを手放して新しいマシンをリースするため、アプリは動き続けます。お客様は実際に使えるコンピュートの分だけお支払いいただきます。
10
すべての内部 API 呼び出しで呼び出し元のロールを確認し、サーバーは接続前にコントロールプレーンの身元を検証し、マシンキーはマシン上で生成されるようになりました。これらの変更により、攻撃を試みられる前に、攻撃手法をまるごと封じます。お客様は何も変更することなく、より強固な保護を得られます。
01
ポータルで行うすべての操作を、安全な API キーを使って、ドキュメント化された REST API(OpenAPI 仕様付き)で自動化できるようになりました。Kinesis を CI/CD、社内ツール、スクリプトに組み込めます。インフラを抱えずに、Infrastructure as Code を。
02
Kinesis に、安全な OAuth サインインに対応した MCP サーバーが登場しました。AI アシスタントやエージェントが、アプリ、Grid、ビルドをデプロイ・管理できます。アシスタントにモデルの公開を頼めば、そのまま実行されます。アイデアから稼働する AI アプリまでの最短ルートです。
03
Grid のオーナーは、各ユーザーが使えるアプリ、インスタンス、GPU の数に上限を設定できます。上限に達すると、ユーザーにはわかりやすい通知が表示されます。共有キャパシティは、すべてのチームにとって公平で予測可能な状態に保たれます。
04
サーバーの追加は、まずどこに接続されているかを選ぶところから始まり、最適な方法が提案されるようになりました。ファイアウォールや NAT の内側にあるマシン向けの Kinesis Remote Reach も含まれます。インバウンドポートを開く必要はありません。オフィスの PC、研究室、オンプレミスのサーバーが、数分で安全に参加できます。
05
クラウドサーバーでは、不審なコンテナの動作を検知して停止し、お客様に報告するセキュリティモニターがデフォルトで動作するようになりました。被害が出た後ではなく、発生したその場で脅威を捕捉します。安心が標準装備です。
06
適切なイメージ、ポート、リソースがあらかじめ設定されたテンプレートから新しいアプリを始められます。よくあるワークロードなら、ドキュメントを読まずに公開できます。新規ユーザーは、より早く最初のアプリを動かせます。
07
アプリ、サーバー、ログの各ページで、配置チェック、作業指示、Grid の状態を一か所で確認できるようになりました。アプリがマシンを待っているときは、どのルールが妨げているのかが正確にわかります。以前はサポートチケットが必要だった問題も、ひと目で解決できます。
08
Kinesis の Windows 向けデスクトップアプリ Spark で、数回のクリックで PC をアカウントにリンクし、一時停止やスケジュール設定ができるようになりました。オフィスや研究室の PC が、本来なら遊んでいる時間にコンピュートを提供します。マシンをいつ稼働させるかは、オーナーが引き続き管理できます。
09
Kinesis は、シークレットと思われる環境変数を検出し、一覧表示や API 全体でその値を非表示にするようになりました。パスワードや API キーがスクリーンショットや画面共有から漏れることはありません。セキュリティのベストプラクティスが標準になります。
10
Spot Instances に GeForce RTX 20 シリーズ以降のカードとワークステーション向け RTX GPU が加わり、正式なモデル名で表示されるようになりました。お客様はより多くの価格帯から選べます。小規模なワークロードにも、手頃でぴったりのハードウェアが見つかります。
01
Grid アプリで、再起動や再デプロイ後も保持される永続ストレージボリュームを最大4つまで使えるようになりました。データベース、モデルキャッシュ、ユーザーのアップロードデータは安全に保たれます。ステートフルなワークロードも、ステートレスなものと同じくらい簡単に Kinesis で実行できます。
02
データセンター向け GPU(A100・H100 クラス)を、ビジュアルなレイアウトデザイナーで分離されたスライスに分割し、各アプリに専用のスライスを割り当てられます。1 基の強力な GPU で、多数の小さなワークロードを安全に処理できるようになりました。より少ないハードウェアで、より多くのことを。
03
Grid で、アイドル状態のアプリから GPU を回収できるようになりました。しきい値は設定可能で、何かを停止する前にはわかりやすい警告が表示されます。希少な GPU は、実際に使っている人の手に戻ります。お金を払っているすべての GPU が、実際に仕事をします。
04
Grid が満杯のとき、アプリは先着順ではなく公平なキューで待機し、順番に実行されるようになりました。1 人のユーザーが共有容量を独占することはできません。すべてのチームが自動的に公平な割り当てを受けられます。
05
Editor と User のロールで Grid を共有し、すべてのアプリの CPU、RAM、GPU、VRAM の使用状況をリアルタイムで確認し、1 つの画面からアプリを停止・再起動できます。Grid のオーナーは共有容量を完全に把握し、管理できます。IT 部門は邪魔をすることなく主導権を保てます。
06
休止中のマシンが復帰する際に GPU が在庫切れの場合、Kinesis は再試行を続けてステータスを表示し、マシンの休止に失敗した場合はオーナーにアラートが届きます。何かが知らないうちに止まったままになることはありません。キャパシティを失うリスクなく、休止による節約を任せられます。
07
App Gallery は、Grid をお持ちの場合、デフォルトでその Grid にデプロイするようになりました。モデルやアプリは、追加の設定なしで、すでに料金を払っているハードウェアに配置されます。自社のコンピュートを活用するのに必要なのはワンクリックだけです。
01
Grid で、自社マシン、オンデマンドのクラウドマシン、Kinesis マーケットプレイスでレンタルした Spot Instances を、ひとつのプールにまとめられるようになりました。ワークロードごとに最適な価格で、コンピュートを数分で拡大・縮小できます。お使いのあらゆる種類のコンピュートを、ひとつのプラットフォーム、ひとつのビューで。
02
SSH キーを一度アップロードすれば、クラウドマシンや BYOC マシンに割り当てて直接アクセスできます。エンジニアは使い慣れたツールでマシンに入れます。キーはお客様のもの、管理もお客様の手に。
03
Grid 内でマシンに優先順位を付け、1 つのアプリを複数の Grid にまたがって実行できます。優先するハードウェアがまず仕事を引き受け、残りのフリートがあふれた分に対応します。より賢い配置で、パフォーマンスは向上し、コストは下がります。
04
1 つのアプリで、yourcompany.com のようなルート(apex)ドメインを含む複数のカスタムドメインを提供できるようになりました。地域別サイト、ブランドのバリエーション、移行を 1 つのデプロイメントから実行できます。すべてのドメインに SSL が自動で適用されます。
05
承認されたサプライヤーは、マシン一式を Kinesis マーケットプレイスに掲載し、新しい Provider Hub で収益を追跡できます。使われずに眠っていたハードウェアが、自らの費用を稼ぎ出すようになります。ネットワーク上の供給が増えれば、レンタルするすべての人にとって選択肢も広がります。
06
A100 データセンター GPU を Grid ページから直接プロビジョニングできるようになりました。大規模なトレーニングや推論のジョブでも、長期契約なしで数分のうちに最上位のハードウェアを利用できます。大きなジョブのときだけスケールアップし、終わったら返却できます。
07
共有された Grid 上で動くアプリは、利用ごとの追加料金や残高チェックなしで、その Grid のマシンを使えるようになりました。Grid のオーナーがキャパシティの料金を一度支払えば、どのチームも自由に使えます。社内でのコンピュートの共有が、ようやくフォルダの共有と同じくらい簡単になりました。
01
ポータルに AI アシスタントが加わりました。ビルドの失敗やアプリのログを読み、何が問題だったかを説明し、Dockerfile の修正案を提示します。チケットの順番待ちなしで、状況に即したサポートを24時間いつでもすぐに受けられます。
02
プロビジョニング中のマシンについて、進行状況、インスタンスの詳細、そして失敗時の再試行・閉じるオプションをリアルタイムで表示するようになりました。今何が起きていて、次に何をすべきかが常にわかります。容量が来るのかどうか、もう推測する必要はありません。
03
アプリの状態が変化するたびに正確に表示されるようになりました。新たに追加された「起動ブロック」状態では、アプリが起動できない理由が説明されます。実行中のアプリへの小さな変更が理由なくブロックされることもなくなりました。混乱が減り、修正も早くなります。
04
クラウドマシンでイメージやコンテナに高速なローカル SSD を使えるようになり、組み込みのインスタンスストレージは別途課金されなくなりました。大規模なモデルの読み込みが速くなり、コストも下がります。より少ない費用で、より高いパフォーマンスを。
05
任意のマシンを固定して、自動で休止状態にならないようにできます。常時稼働のサービスはいつでも準備万端のまま、それ以外のフリートはコストを節約し続けます。マシンごとに、節約と信頼性の両方を手にできます。
06
アプリへのトラフィックは、再構築された App Proxy レイヤーを経由するようになりました。このレイヤーは自らの健全性をチェックし、ルートと証明書を自動で修復します。ネットワークの一部に不調があっても、エンドポイントは稼働し続けます。お客様側で何も変更することなく、信頼性が向上します。
07
Grid とサーバーの新しいリスト表示に、検索、ページネーション、アプリ別ビューが加わりました。数百台のマシンを持つチームでも、目的のマシンを数秒で見つけられます。ポータルはフリートの規模に合わせてスケールします。
01
どのプロジェクトやアプリにも適切なロールでメンバーを招待し、アプリ内通知とメール通知で全員に最新情報を届けられます。ログインを共有することなく、チームが 1 か所で協働できます。アクセス権は明確で、いつでも削除できます。
02
認証アプリまたはパスキー/セキュリティキーでアカウントを保護でき、バックアップコードや信頼済みデバイスにも対応しています。万一パスワードが漏えいしても、ワークロードと請求情報は安全に保たれます。数秒で有効にできるエンタープライズレベルのセキュリティです。
03
Docker イメージファイルを Kinesis に直接アップロードしてデプロイできます。レジストリは不要です。エアギャップ環境でのビルド、プライベートモデル、レジストリを持たないチームも、アップロード 1 回で公開できるようになりました。
04
インストールコマンドひとつと、いつでも再生成できる個人トークンで、自前のコンピュートを持ち込めます。サーバーの追加は1分で済み、アクセスはお客様の管理下に置かれます。1台から100台へのスケールも、コマンドを1回実行するだけです。
05
すべてのプロジェクトとアプリに、誰がいつ何を変更したかを示すアクティビティ履歴が加わりました。チームはどんな変更も数秒で追跡できます。監査や事後分析が簡単になります。
06
カード、電信送金、ACH で支払い、すべてのマシンが記載された請求書を受け取り、すべての請求とクレジットを CSV でダウンロードできます。経理チームはサポートに問い合わせることなく必要な書類を入手できます。Kinesis は、大企業の購買スタイルにもフィットするようになりました。
07
アプリの複数インスタンスのログを、自分で配置したタブで同時にストリーミング表示できます。特定のマシンでしか起きない問題も簡単に見つけられます。スケールアウトしたアプリのデバッグで、ページを行き来する必要はもうありません。
01
プロビジョニングの前に、GPU と CPU のリアルタイムの空き状況を「需要が高い」ラベル付きで確認できます。マシンが在庫切れでも注文でき、空き次第 Kinesis が確保します。空いた GPU をつかまえるためにページを何度も更新する必要はもうありません。
02
アプリの設定に、カード形式の選択肢を備えたわかりやすい「実行」タブと「コンピュート戦略」タブが加わりました。アプリをどう動かすかを指定するだけで、ハードウェアの詳細は Kinesis が処理します。新しいユーザーはより早くデプロイを成功させられ、上級者は引き続き細かく制御できます。
03
残高でマシンをあとどれくらい動かせるかを確認し、重要なマシンを自動シャットダウンから保護し、早めにメールで警告を受け取れます。残高不足による予期せぬ停止はもうありません。先を見越した計画が簡単になります。
04
重大な障害が発生したマシンは自動で再起動して復旧するようになり、不具合のあるマシンはワンクリックで新しいマシンに交換できます。アプリのダウンタイムが減り、チームがサポートに費やす時間も減ります。付きっきりにならなくても、信頼性を保てます。
05
ログの保存期間の選択、ダウンロードや削除、履歴の閲覧、マシンのシステムログの表示を、ポータルから行えます。SSH セッションを使わずに、数分でデバッグできます。保持するデータ量は、コストとコンプライアンスの観点からお客様が決められます。
06
App Gallery に、Gemma 4、Qwen 3.5、Qwen 3.6 などの最新オープンモデルが加わりました。新しいモデルを、公開されたその週にワンクリックで試せます。オープンソース AI の最新動向に追従するのに、余計なエンジニアリングは要りません。
07
プライベート Docker レジストリから、Kinesis が変更の保存前に検証する認証情報を使ってデプロイできます。パスワードが間違っていれば、アプリが壊れるのではなく、フォーム上で知らせます。プライベートイメージも、パブリックイメージと同じくらい簡単に公開できます。
01
Grid で、AWS、Azure、Kinesis のクラウドマシンを、GPU と CPU の選択肢を並べてポータルから直接オンデマンドでプロビジョニングできるようになりました。個別のクラウドアカウントやコンソールを管理する必要はありません。自社のハードウェアとオンデマンドのクラウドキャパシティが一か所にまとまります。
02
任意のアプリに独自ドメインを設定でき、SSL 証明書の発行と管理は Kinesis が行います。ユーザーに表示されるのは当社ではなく、お客様のブランドです。証明書の面倒な作業は一切不要です。
03
Grid のオーナーが、自分のマシンを他のユーザーやチームと共有できるようになりました。IT 管理者はキャパシティを一度購入するだけで、すべてのチームにアクセスを提供できます。高価な GPU が1つのアカウントに閉じ込められることなく、必要とするすべての人に使われます。
04
ワンクリックでマシンをスリープ、起動、再起動でき、各ステップで状態がはっきりわかります。いつコストを節約し、いつ容量を準備しておくかはお客様が決められます。SSH もスクリプトも不要なシンプルな操作で、主導権はお客様の手に。
05
専用マシンの料金が事前に表示されるようになり、フリートのコスト概要にまとめられ、他のすべてと同じ請求書に記載されるようになりました。財務チームは複数の請求書ではなく、わかりやすい1枚の請求書を確認できます。請求書が届く前に、フリートのコストを常に把握できます。
06
Kinesis は、Docker タグが新しいイメージを指したことを検知し、最新バージョンの取得を提案するようになりました。アプリがプッシュしたばかりのコードで動いているかどうか、常に把握できます。古いビルドのまま気づかず動き続ける再デプロイとはもう無縁です。
07
アプリのフォームが、イメージからポートを提案し、エントリーポイントの上書きや共有メモリの設定に対応し、シェルベースのイメージも動かし続けられるようになりました。これまでカスタムラッパーが必要だったイメージも、そのまま動きます。既存のソフトウェアの多くが、最初の試行でデプロイできます。
08
AWS、Azure、Kinesis Cloud でプロビジョニングするすべてのクラウドマシンのストレージサイズを選べるようになりました。大きなモデルやデータセットも回避策なしで収まります。固定のデフォルトではなく、必要なディスク分だけお支払いください。
01
GitHub リポジトリを接続してブランチを選ぶだけで、Kinesis がビルドとデプロイを行います。Docker イメージは不要で、ビルドログをリアルタイムで確認でき、デプロイメント履歴も残ります。ブランチへのプッシュのたびに自動で再ビルド・再デプロイされるので、パイプラインを書かずに CI/CD を実現できます。
02
リポジトリに Dockerfile がなくても大丈夫です。Kinesis がプロジェクトに必要なものを検出し、AI が Dockerfile を作成して、その様子をリアルタイムでストリーミング表示します。コンテナに不慣れなチームにとって最大の障壁がなくなります。DevOps の知識が少なくても、より多くのコードを本番環境に届けられます。
03
休止中のマシンが、アプリに必要とされると自動的に復帰するようになりました。手作業でマシンを起動し直す手間なく、休止による節約効果を得られます。コンピュートはワークロードが求めるときにはそこにあり、求めないときは休止しています。
04
新しいビジュアルテーマと再設計されたプロジェクトページ・アプリページで、ステータスがひと目でわかり、プロジェクト検索も組み込まれています。多くのアプリを持つチームも、目的のものをすばやく見つけられます。日々の管理に必要なクリック数が減ります。
05
自動チャージに保護機能が加わりました。カードへの請求が繰り返し失敗すると、ループし続けるのではなく自動的にオフになってお知らせします。支払い失敗の連鎖に陥ることはありません。請求は予測可能で透明なまま保たれます。
06
Kinesis Cloud に新たなデータセンターパートナーが加わり、ストレージがマシンに自動でアタッチされるようになりました。お客様は、より多くのロケーションと GPU の選択肢から選べます。供給が増えれば、可用性も価格も向上します。
07
すべての GitHub ビルドの完全なログが保存されるようになり、ビルド中もビルド後もずっと読めます。ビルドが失敗したら、ワンクリックで理由がわかります。何が起きたかを知るためにビルドをやり直す必要はなく、数分で修正できます。
01
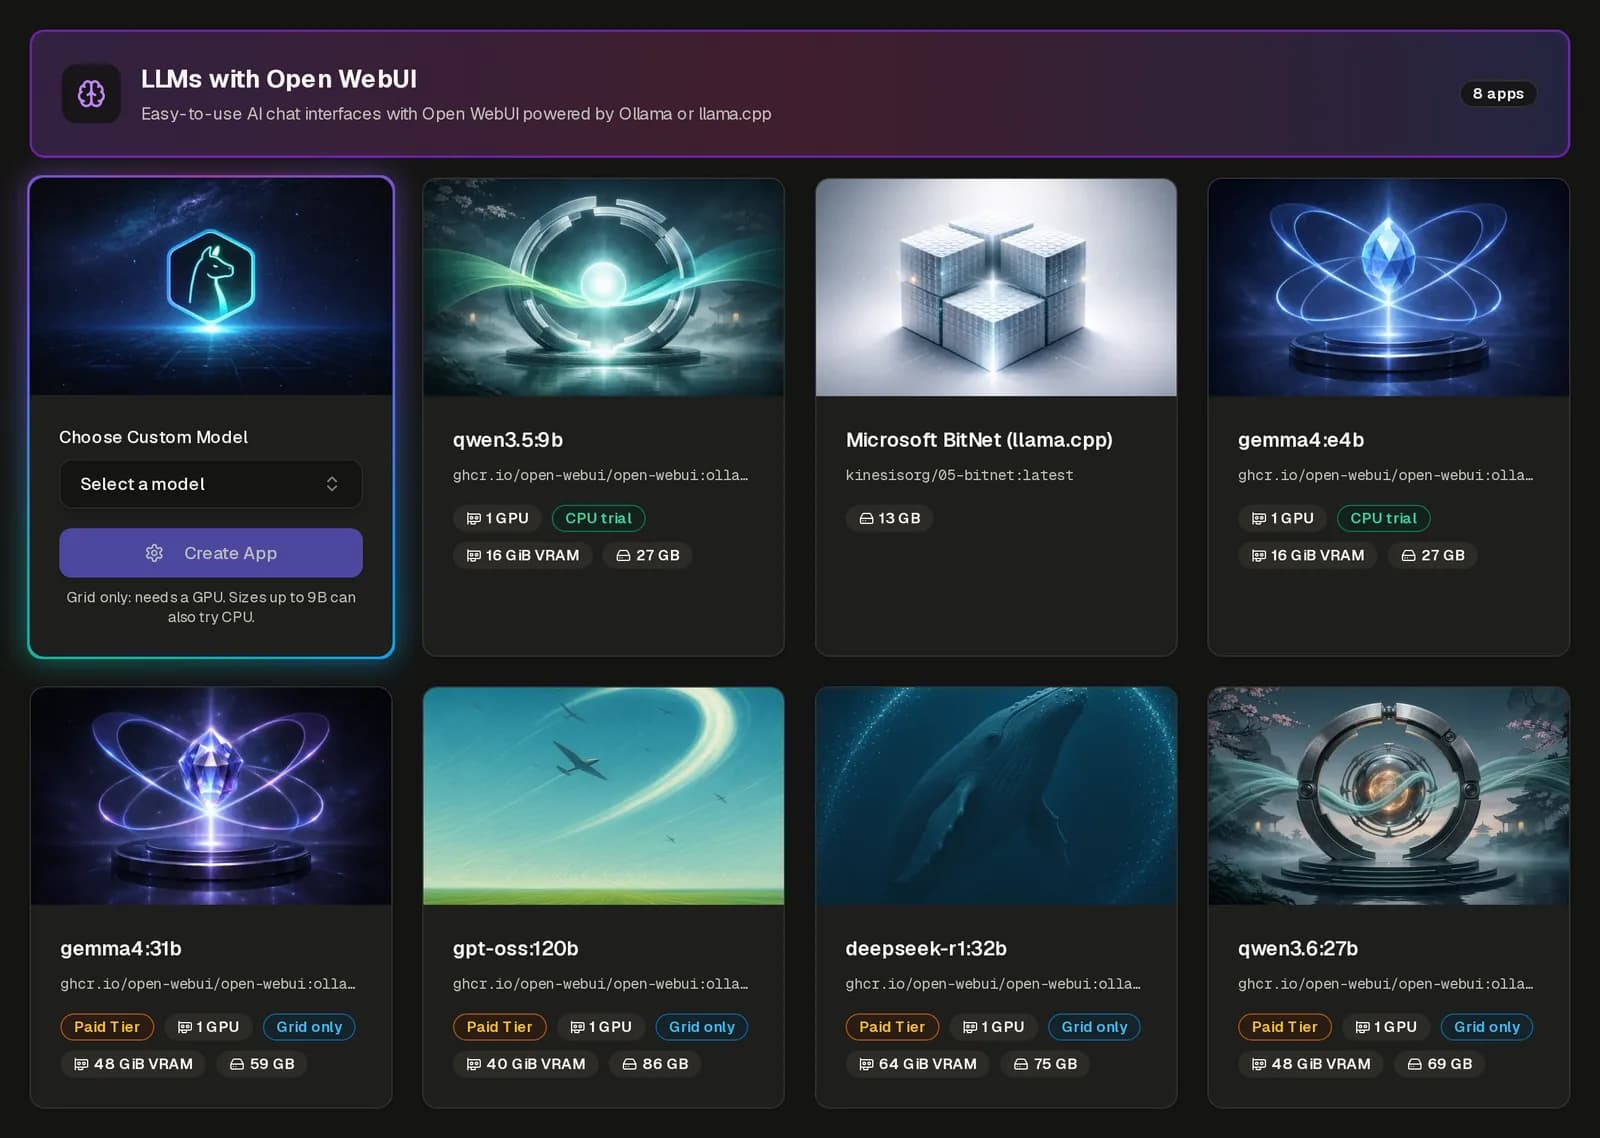
サインアップ前でも誰でも Kinesis App Gallery を閲覧し、実行したい Ollama モデルをワンクリックで選べるようになりました。チームは何かを決める前に、何が実行できるかを確認できます。「このモデルを試してみたい」から稼働中のエンドポイントまで、週末をつぶしてセットアップする必要はなく、数分で完了します。
02
新しい「タスク完了」再起動ポリシーにより、バッチジョブ、データパイプライン、単発のタスクを 1 回だけ実行し、終了時にきれいに停止できるようになりました。これまでは、完了したジョブが何度も再起動を繰り返し、コンピュートを無駄にすることがありました。今は仕事の分だけを支払い、仕事が終わればジョブは停止します。
03
実行中のアプリがない専用マシンは、自動的に休止するようになりました。夜間やプロジェクトの合間に遊んでいる GPU に料金を払う必要はもうありません。マシンはお客様のもののまま、必要なときにすぐ復帰できます。
04
アプリの設定をエクスポートして新しいアプリにインポートしたり、既存のアプリをワンクリックで複製したりできます。ステージングから本番への構成の移行や、チームメイトとの共有のために、1項目ずつ作り直す必要はもうありません。エクスポートしたファイルには使用可能なすべての値が記載されているので、編集も簡単かつ安全です。
05
環境変数で、アプリ自身のドメインなど Kinesis が自動で埋めるプレースホルダーを使えるようになり、より高速な一括編集モードも加わりました。アプリの設定は一度だけで、アドレスが変わっても正しい状態が保たれます。手作業での編集が減れば、デプロイの失敗も減ります。
06
Kinesis ロードバランサーの背後にあるアプリが TLS 上で gRPC を提供できるようになり、Web アプリはスティッキーセッションによって各訪問者を同じインスタンスに留められるようになりました。最新の API やステートフルな Web アプリも、コードを変更せずにスケールアウトできます。インスタンスをいくつ動かしても、ユーザーは高速で一貫した体験を得られます。
07
ポータルが起動前に Docker イメージを検証し、イメージ自体からストレージのサイズを決めるようになりました。ミスはデプロイの失敗ではなく、フォーム上で見つかります。驚きが減り、エラーログを読む時間も減ります。