

Il control plane per le GPU di tutto il mondo
Il mondo ha comprato le GPU. Nessuno ha costruito la Grid.
Kinesis la costruisce per te. Non ti serve hardware tuo: parti con la capacità Kinesis o collega i cloud che preferisci, e Kinesis trova le GPU migliori al prezzo che stabilisci tu. Avvia un LLM privato dalla App Gallery in pochi clic o fai il deploy delle tue app. Kinesis le mantiene in esecuzione e tutti vedono lo stesso quadro.
 Piattaforma di deployment di app dell’anno 2026CIOReviewVincitore dello Stevie® Award 2025Nuovo servizio dell’anno
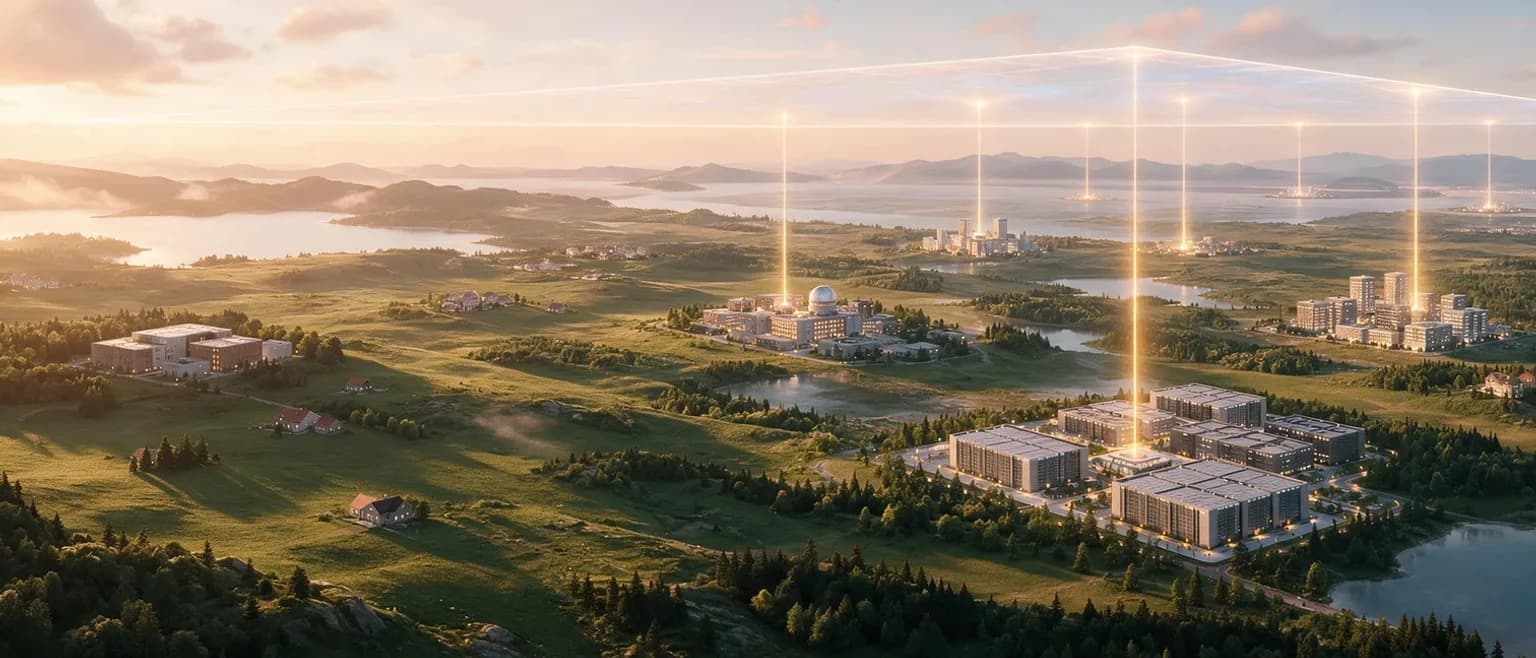
Come funziona
Collega potenza di calcolo da ovunque e lascia il resto a Kinesis.
Porta gli account cloud che preferisci, parti con la capacità Kinesis, o entrambe le cose.
Collega la tua potenza di calcolo
Parti con la capacità Kinesis, aggiungi una chiave API per ogni cloud che usi e collega i server che hai già con un solo comando.
Kinesis lo esegue e lo mantiene attivo
Kinesis trova le GPU che servono alla tua app su ogni fonte, la colloca sulla soluzione migliore e la scala in base alla domanda. Quando una macchina si guasta alle 3 di notte, ne avvia una sostitutiva in autonomia.
Vedi tutto in un unico posto
Ogni app, macchina e persona della tua organizzazione: cosa gira dove, chi usa cosa e quanto costa ogni progetto.
Esempio illustrativo
Operativi in fretta
Nel nostro benchmark, Kinesis è stata 4,1× più veloce di AWS e 6,3× più veloce di Azure.
Abbiamo cronometrato un lavoro dall'inizio alla fine, registrazione inclusa: un endpoint HTTPS di un modello in produzione (vLLM con Gemma 4 31B FP8) su una NVIDIA H100.
- Kinesiscirca 27 min · 93 passaggi
- AWScirca 1,85 h · 337 passaggi
- Azurecirca 2,8 h · 483 passaggi
HTTPS su un dominio gestito è incluso: 0 passaggi per gateway e TLS su Kinesis, contro 119 su AWS e 219 su Azure.
Kinesis Builder Time-to-Value Benchmark, maggio 2026. Tempo reale dalla registrazione all'endpoint online; un passaggio è un clic, un comando o un campo di un modulo.
Trova la soluzione giusta
Da dove parti?
La maggior parte dei team arriva da noi in una di cinque situazioni. Scegli quella che somiglia di più alla tua.
- 1Vogliamo la nostra AI, senza mandare fuori i nostri dati né pagare a token.App GalleryApp Gallery ↓
- 2Passiamo più tempo a cercare GPU che a usarle.Kinesis OneCloudKinesis OneCloud ↓
- 3Abbiamo più sviluppatori che GPU, e c'è sempre qualcuno in attesa.Kinesis OneTeamKinesis OneTeam ↓
- 4Ci serve una flotta di GPU per il lavoro batch, senza doverla gestire noi.Kinesis BatchesKinesis Batches ↓
- 5Le nostre GPU restano inattive per ore ogni giorno.Kinesis MarketplaceKinesis Marketplace ↓
Per i team che vogliono la propria AI
Il tuo LLM privato, a pochi clic di distanza.
Scegli un modello open come gpt-oss, Qwen, Gemma o DeepSeek, seleziona le GPU e il massimo che vuoi pagare, poi fai clic su Crea app. Kinesis offre al tuo team una chat privata con un proprio indirizzo HTTPS. I tuoi prompt non arrivano mai a un fornitore di modelli e paghi le ore GPU, non i token. Tieni le API dei modelli di frontiera per i problemi più difficili.
- Open WebUI con Ollama o llama.cpp, già configurato per te. Scegli un modello in evidenza o indica il nome di qualsiasi modello Ollama.
- E accanto, altre app pronte all'uso: JupyterLab, Whisper, code-server, n8n, Qdrant e altre ancora.
- Non hai GPU tue? Parti con la capacità Kinesis o collega il tuo account AWS o Azure.
I modelli piccoli si possono provare su CPU. I modelli più grandi richiedono una GPU nel tuo Grid.
1 · Scegli un modello
- gpt-oss:120b1 GPU
- qwen3.6:27b1 GPU
- deepseek-r1:32b1 GPU
- gemma4:e4bProva su CPU
2 · Scegli le GPU e il tuo prezzo
3 · La tua chat privata è online
Riassumi questo contratto con il fornitore in cinque punti.
Ecco i termini principali: durata di 24 mesi, pagamento a 60 giorni e…
Illustrativo · modelli come elencati nella App Gallery
Per i team che hanno bisogno di più GPU
Un solo cloud non basta mai. Le Kinesis Grid li rendono uno solo.
Collega i cloud che preferisci con una chiave API e mantieni i contratti e i crediti che hai già. Kinesis trova le GPU che ti servono su tutti, aggiunge capacità Kinesis quando ne serve di più, mantiene il tuo lavoro in esecuzione quando una macchina spot scompare e ti offre un'unica vista su ogni log e ogni dollaro.
- Chiavi API per 20 hyperscaler e neocloud. I tuoi account, contratti e crediti restano tuoi.
- Le macchine spot recuperate dal provider vengono sostituite automaticamente.
- Nulla viene eseguito oltre il prezzo massimo che hai impostato.
Kinesis ha controllato ogni fonte che hai collegato
- I tuoi crediti cloudusata per prima3 GPUprepagato
- Capacità spotsostituita automaticamente3 GPU0,89 USD/h
- I tuoi servergià pagato2 GPUdi proprietà
- Cloud on demandoltre il tuo prezzo massimosaltato1,62 USD/h
8 / 8
GPU trovate
-45%
spot vs on demand
1 deploy
ogni fonte
Illustrativo · Kinesis assegna il lavoro solo dove il tuo prezzo viene rispettato
Per inferenza batch, rendering e fine-tuning
Una flotta di GPU, senza fatica.
Non tutti i job hanno bisogno di una GPU da data center. La tua Kinesis Grid distribuisce inferenza batch, rendering e fine-tuning su schede GeForce RTX serie 30, 40 e 50 e schede RTX workstation, a partire da 0,03 USD all'ora, e fa avanzare il lavoro mentre le macchine vanno e vengono. Vedi il costo massimo della tua esecuzione prima di registrarti.
- Ogni prezzo indicato è il massimo che paghi per ora-GPU.
- Scala su tante GPU, un job per GPU.
Kinesis Batches gira su GPU della community e dei partner. La tua Grid non assegna mai lavoro a hardware della community, a meno che tu non scelga Kinesis Batches.
- RTX 5060 Ti16 GB0,12 USD/h
- RTX 5070 Ti16 GB0,27 USD/h
- RTX 508016 GB0,35 USD/h
- RTX 509032 GB0,61 USD/h
Serie RTX 30 e 40 da 0,03 USD/h · anche schede workstation RTX 6000
Illustrativo · ogni prezzo indicato è il massimo che paghi
Per chiunque abbia GPU inattive
Fatti pagare per le ore in cui le tue GPU non lavorano.
Un PC da gaming resta spento per gran parte della giornata. Un data center vende alcune delle sue ore e perde le altre per sempre. Kinesis porta i clienti e si occupa di fatturazione e assistenza, e tu vieni pagato per ore che altrimenti andrebbero sprecate.
- Gamer e sale giochi: installa l'app Spark, scegli le tue ore, vieni pagato.
- Data center e neocloud: vendiamo la vostra capacità inattiva come Spot Instances.
- Stima i tuoi guadagni prima di collegare qualsiasi cosa.
Disponibile 23:00 – 8:00. Di giorno torna a essere tuo.
Illustrativo
Per sicurezza, privacy e sovranità
L'intera piattaforma, privata quanto ti serve.
Alcune organizzazioni non possono condividere con altre aziende il software che gestisce le loro GPU, né lasciarne la gestione a qualcuno di esterno. Non per questo dovrebbero rinunciare a strumenti moderni. Kinesis Private è disponibile in due livelli, ed entrambi eseguono lo stesso Kinesis che i tuoi team userebbero ovunque.
- Isolato: un deployment dedicato, separato da ogni altro cliente e gestito da Kinesis.
- Completamente privato: tutto, compreso il software che gestisce le tue GPU, gira nel tuo data center. Kinesis non è coinvolta.
Completamente privato
Il tuo ambiente
Chiavi, log e audit trail restano nel tuo data center.
Cosa abbiamo rilasciato
78 release finora quest'anno.
Mettiamo qualcosa di nuovo nelle mani dei clienti quasi ogni settimana. Eccone alcune degli ultimi tre mesi. Leggi il changelog completo →
Ottobre 2026
Single sign-on aziendale
Accedi con il tuo identity provider, verifica i tuoi domini e richiedi l'SSO a ogni membro.
Ottobre 2026
Kinesis dentro Claude
Collega Kinesis a Claude e gestisci i tuoi deployment dall'assistente che usi già.
Ottobre 2026
Rollback con un clic
Riporta un'app distribuita da GitHub a qualsiasi build precedente, senza ricostruirla.
Settembre 2026
Una REST API pubblica e un server MCP
Tutto ciò che c'è nel portale, dai tuoi script e dai tuoi agenti.
Settembre 2026
Quote per persona sulle Grid condivise
Limita GPU, app e istanze per persona su ogni Grid.
Settembre 2026
Qualsiasi macchina, dietro qualsiasi firewall
PC d'ufficio, laboratori e server on-prem si uniscono in pochi minuti, senza porte in entrata.
Agosto 2026
Frazionamento delle GPU con MIG
Suddividi le GPU da data center supportate in slice isolate.
Agosto 2026
Scheduling fair share
Quando le GPU scarseggiano, ogni team ha il suo turno.
Riconoscimenti e stampa
Cosa dicono gli altri del nostro lavoro.
Piattaforma di deployment di app dell’anno 2026
CIOReview
- Managed Compute Cloud Solution of the Year 2026, CIOReview
- Bronze Stevie® Award 2025, New Service of the Year
- Fierce NetworkCan an old networking concept solve today’s compute shortage?
- IEEE SpectrumThe AI boom is giving rise to GPU-as-a-Service
- SiliconANGLEMulticloud GPU compute-as-a-service startup Kinesis Network goes fully serverless
- InformationWeekThe cloud you want versus the cloud you need
La nostra storia
In questo momento, da qualche parte, un team di ricerca aspetta giorni per una GPU. Da qualche altra parte, una GPU costosissima si sta facendo un pisolino.
Il mondo sta spendendo centinaia di miliardi di dollari in hardware per l'AI, e gran parte di esso resta ancora inattivo. Non perché nessuno ne abbia bisogno, ma perché chi ne ha bisogno non riesce a raggiungerlo. La capacità è sparsa tra cloud, data center ed edifici, ognuno con la propria console, il proprio contratto, la propria rete e la propria fattura.
Un tempo l'elettricità aveva lo stesso problema. Non è cresciuta quando qualcuno ha costruito un generatore più grande. È cresciuta quando le reti elettriche hanno collegato generatori di ogni dimensione a ogni presa, e quando contatori e regole condivise hanno permesso a persone che non si erano mai incontrate di comprare e vendere energia in sicurezza. La potenza di calcolo oggi è dove si trovava l'elettricità prima della rete elettrica.
Due di noi, Baris e Hamza, si sono conosciuti in Microsoft nel 2005 e da allora costruiscono insieme. Toshi e David provengono da Microsoft, Mozilla, Asana e Meta. Prima di Kinesis, Baris e Hamza hanno costruito C0D3R, una rete decentralizzata di decine di migliaia di macchine che nel tempo ha gestito migliaia di miliardi di relay. Ci ha dimostrato che macchine sparse in tutto il mondo possono comportarsi come un unico sistema, se qualcuno fa il paziente lavoro di collegarle, proteggerle e renderle facili da usare.
Così nel 2024 abbiamo fondato Kinesis per costruire quella Grid per il calcolo: prima all'interno di ogni organizzazione, così che ogni GPU che usa funzioni come un unico sistema, e poi tra organizzazioni, così che la capacità inutilizzata arrivi a chi ne ha bisogno.
Il tuo calcolo. Il nostro calcolo. Il calcolo di tutti.
Se lavori con l'AI, possiedi GPU o ti interessa semplicemente dove sta andando il calcolo, saremo felici di sentirti.
Baris Saydag
CEO e CTO
Hamza Ak
COO
Toshihito Kikuchi
Chief Engineer
David Ding
Head of UX
Contattaci
Parla con chi lo sta costruendo.
Clienti
Dicci cosa esegui e dove. Ti diremo onestamente se Kinesis fa per te, e dove no.
Parlaci →Investitori
Dove sta andando Kinesis e come intendiamo costruire la Grid per il calcolo di tutto il mondo.
Relazioni con gli investitori →Stampa
Interviste, briefing e approfondimenti sul mercato del calcolo.
Richieste della stampa →