

O control plane para as GPUs do mundo
O mundo comprou as GPUs. Ninguém construiu o Grid.
A Kinesis constrói isso. Sem precisar de hardware próprio: comece com a capacidade da Kinesis ou conecte as nuvens que você preferir, e a Kinesis encontra as melhores GPUs pelo preço que você definir. Lance um LLM privado a partir da App Gallery em poucos cliques, ou implante seus próprios apps. A Kinesis os mantém rodando, e todos veem o mesmo panorama.
 Plataforma de Implantação de Apps do Ano 2026CIOReviewVencedora do Stevie® Award 2025Novo Serviço do Ano
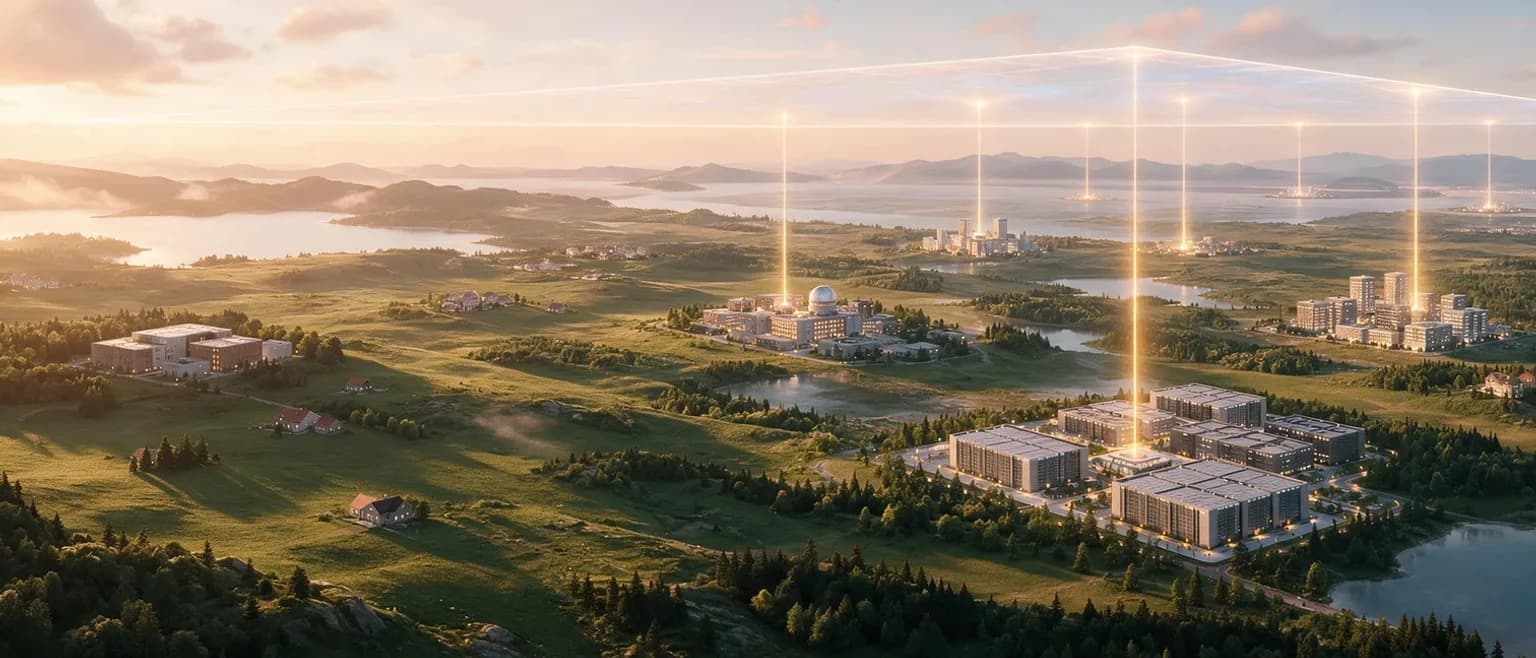
Como funciona
Conecte computação de qualquer lugar e deixe o resto com a Kinesis.
Traga as contas de nuvem que preferir, comece com a capacidade da Kinesis, ou as duas coisas.
Conecte sua computação
Comece com capacidade da Kinesis, adicione uma chave de API para cada nuvem que você usa e conecte os servidores que já tem com um único comando.
A Kinesis executa e mantém tudo rodando
A Kinesis encontra as GPUs de que seu app precisa em todas as fontes, coloca-o na melhor opção e o escala conforme a demanda. Quando uma máquina falha às 3 da manhã, ela sobe uma substituta sozinha.
Veja tudo em um só lugar
Cada app, máquina e pessoa em toda a sua organização: o que roda onde, quem usa o quê e quanto custa cada projeto.
Exemplo ilustrativo
Pronto para rodar
No nosso benchmark, a Kinesis foi 4,1× mais rápida que a AWS e 6,3× mais rápida que o Azure.
Cronometramos um trabalho de ponta a ponta, cadastro incluído: um endpoint HTTPS de modelo em produção (vLLM com Gemma 4 31B FP8) em uma NVIDIA H100.
- Kinesiscerca de 27 min · 93 etapas
- AWScerca de 1,85 h · 337 etapas
- Azurecerca de 2,8 h · 483 etapas
HTTPS em um domínio gerenciado já vem incluído: 0 etapas de gateway e TLS na Kinesis, contra 119 na AWS e 219 no Azure.
Kinesis Builder Time-to-Value Benchmark, maio de 2026. Tempo real do cadastro até o endpoint no ar; uma etapa é um clique, um comando ou um campo de formulário.
Encontre o seu encaixe
De onde você está partindo?
A maioria das equipes nos procura em uma de cinco situações. Escolha a que mais se parece com a sua.
- 1Queremos nossa própria IA, sem enviar nossos dados para fora nem pagar por token.App GalleryApp Gallery ↓
- 2Passamos mais tempo caçando GPUs do que usando.Kinesis OneCloudKinesis OneCloud ↓
- 3Temos mais desenvolvedores do que GPUs, e sempre tem alguém esperando.Kinesis OneTeamKinesis OneTeam ↓
- 4Precisamos de uma frota de GPUs para trabalho em lote, sem ter que operá-la nós mesmos.Kinesis BatchesKinesis Batches ↓
- 5Nossas GPUs ficam ociosas por horas todos os dias.Kinesis MarketplaceKinesis Marketplace ↓
Para equipes que querem ter a própria IA
Seu próprio LLM privado, a poucos cliques de distância.
Escolha um modelo aberto como gpt-oss, Qwen, Gemma ou DeepSeek, defina as GPUs e o máximo que você vai pagar, e clique em Criar app. A Kinesis entrega à sua equipe um chat privado com endereço HTTPS próprio. Seus prompts nunca vão para um fornecedor de modelos, e você paga por horas de GPU, não por tokens. Deixe as APIs de fronteira para os problemas mais difíceis.
- Open WebUI com Ollama ou llama.cpp, já configurado para você. Escolha um modelo em destaque ou informe o nome de qualquer modelo do Ollama.
- E mais apps prontos para rodar ao lado: JupyterLab, Whisper, code-server, n8n, Qdrant e outros.
- Não tem GPUs próprias? Comece com a capacidade da Kinesis ou conecte sua conta da AWS ou do Azure.
Modelos pequenos podem ser testados em CPU. Modelos maiores precisam de uma GPU no seu Grid.
1 · Escolha um modelo
- gpt-oss:120b1 GPU
- qwen3.6:27b1 GPU
- deepseek-r1:32b1 GPU
- gemma4:e4bTeste em CPU
2 · Escolha as GPUs e seu preço
3 · Seu chat privado está no ar
Resuma este contrato de fornecedor em cinco tópicos.
Estes são os principais termos: prazo de 24 meses, pagamento em 60 dias, e…
Ilustrativo · modelos conforme listados na App Gallery
Para equipes que precisam de mais GPUs
Uma única nuvem nunca é suficiente. Os Kinesis Grids os transformam em um só.
Conecte as nuvens que preferir com uma chave de API e mantenha os contratos e créditos que você já tem. A Kinesis encontra as GPUs de que você precisa em todas elas, adiciona capacidade da Kinesis quando você precisa de mais, mantém seu trabalho rodando quando uma máquina spot desaparece e oferece uma única visão de cada log e de cada dólar.
- Chaves de API para 20 hyperscalers e neoclouds. Suas contas, contratos e créditos continuam sendo seus.
- Máquinas spot recuperadas pelo provedor são substituídas automaticamente.
- Nada roda acima do preço máximo que você definir.
A Kinesis verificou todas as fontes que você conectou
- Seus créditos de nuvemusado primeiro3 GPUspré-pago
- Capacidade spotsubstituída automaticamente3 GPUsUS$ 0,89/h
- Seus próprios servidoresjá pagos2 GPUspróprias
- Nuvem sob demandaacima do seu preço máximoignoradoUS$ 1,62/h
8 / 8
GPUs encontradas
-45%
spot vs. sob demanda
1 deploy
todas as fontes
Ilustrativo · a Kinesis só aloca trabalho onde o seu preço é atendido
Para inferência em lote, renderização e fine-tuning
Uma frota de GPUs, sem complicação.
Nem todo job precisa de uma GPU de data center. Seu Kinesis Grid distribui inferência em lote, renderização e fine-tuning entre placas GeForce RTX das séries 30, 40 e 50 e placas RTX workstation, a partir de US$ 0,03 por hora, e mantém o trabalho andando enquanto as máquinas entram e saem. Você vê o máximo que sua execução pode custar antes de se cadastrar.
- Cada preço listado é o máximo que você paga por GPU-hora.
- Escale horizontalmente em várias GPUs, um job por GPU.
O Kinesis Batches roda em GPUs da comunidade e de parceiros. Seu Grid nunca aloca trabalho em hardware da comunidade, a menos que você escolha o Kinesis Batches.
- RTX 5060 Ti16 GBUS$ 0,12/h
- RTX 5070 Ti16 GBUS$ 0,27/h
- RTX 508016 GBUS$ 0,35/h
- RTX 509032 GBUS$ 0,61/h
Séries RTX 30 e 40 a partir de US$ 0,03/h · também placas de workstation RTX 6000
Ilustrativo · cada preço listado é o máximo que você paga
Para quem tem GPUs ociosas
Seja pago pelas horas em que suas GPUs não estão trabalhando.
Um PC gamer fica desligado a maior parte do dia. Um data center vende parte das suas horas e perde o restante para sempre. A Kinesis traz os clientes e cuida da cobrança e do suporte, e você é pago por horas que, de outra forma, seriam desperdiçadas.
- Gamers e lan houses: instalem o app Spark, escolham seus horários e sejam pagos.
- Data centers e neoclouds: vendemos sua capacidade ociosa como Spot Instances.
- Estime seus ganhos antes de conectar qualquer coisa.
Disponível das 23h às 8h. Sua de novo durante o dia.
Ilustrativo
Para segurança, privacidade e soberania
Toda a plataforma, tão privada quanto você precisar.
Algumas organizações não podem compartilhar com outras empresas o software que gerencia suas GPUs, nem deixar que alguém de fora o opere. Elas não deveriam ter que abrir mão de ferramentas modernas por causa disso. O Kinesis Private vem em dois níveis, e ambos rodam a mesma Kinesis que suas equipes usariam em qualquer outro lugar.
- Isolado: uma implantação dedicada, separada de todos os outros clientes e operada pela Kinesis.
- Totalmente privado: tudo, inclusive o software que gerencia suas GPUs, roda no seu data center. A Kinesis não participa.
Totalmente privado
Seu ambiente
Chaves, logs e trilha de auditoria ficam no seu data center.
O que lançamos
78 lançamentos até agora neste ano.
Colocamos algo novo nas mãos dos clientes quase toda semana. Aqui estão alguns dos últimos três meses. Leia o changelog completo →
Outubro de 2026
Single sign-on corporativo
Faça login com o seu provedor de identidade, verifique seus domínios e exija SSO para todos os membros.
Outubro de 2026
Kinesis dentro do Claude
Conecte a Kinesis ao Claude e gerencie seus deploys pelo assistente que você já usa.
Outubro de 2026
Rollback com um clique
Faça o rollback de um app implantado pelo GitHub para qualquer build anterior, sem reconstruir.
Setembro de 2026
Uma API REST pública e um servidor MCP
Tudo o que existe no portal, a partir dos seus scripts e dos seus agentes.
Setembro de 2026
Cotas por pessoa em Grids compartilhados
Limite GPUs, apps e instâncias por pessoa em cada Grid.
Setembro de 2026
Qualquer máquina, atrás de qualquer firewall
PCs de escritório, laboratórios e servidores on-premises entram em minutos, sem portas de entrada.
Agosto de 2026
Fatiamento de GPU com MIG
Divida GPUs de data center compatíveis em fatias isoladas.
Agosto de 2026
Agendamento com divisão justa
Quando faltam GPUs, cada equipe tem a sua vez.
Reconhecimento e imprensa
O que outras pessoas disseram sobre o nosso trabalho.
Plataforma de Implantação de Apps do Ano 2026
CIOReview
- Managed Compute Cloud Solution of the Year 2026, CIOReview
- Bronze Stevie® Award 2025, Novo Serviço do Ano
- Fierce NetworkCan an old networking concept solve today’s compute shortage?
- IEEE SpectrumThe AI boom is giving rise to GPU-as-a-Service
- SiliconANGLEMulticloud GPU compute-as-a-service startup Kinesis Network goes fully serverless
- InformationWeekThe cloud you want versus the cloud you need
Nossa história
Neste exato momento, em algum lugar, uma equipe de pesquisa está esperando dias por uma GPU. Em outro lugar, uma GPU caríssima está tirando uma soneca.
O mundo está gastando centenas de bilhões de dólares em hardware de IA, e boa parte dele ainda fica ociosa. Não porque ninguém precise, mas porque quem precisa não consegue chegar até ele. A capacidade está espalhada por nuvens, data centers e edifícios, cada um com seu próprio console, contrato, rede e fatura.
A eletricidade já teve o mesmo problema. Ela não escalou quando alguém construiu um gerador maior. Ela escalou quando as redes elétricas conectaram geradores de todos os tamanhos a todas as tomadas, e quando medidores e regras compartilhadas permitiram que pessoas que nunca tinham se encontrado comprassem e vendessem energia com segurança. A computação está onde a eletricidade estava antes da rede elétrica.
Dois de nós, Baris e Hamza, se conheceram na Microsoft em 2005 e constroem coisas juntos desde então. Toshi e David vieram da Microsoft, Mozilla, Asana e Meta. Antes da Kinesis, Baris e Hamza construíram a C0D3R, uma rede descentralizada de dezenas de milhares de máquinas que serviu trilhões de relays ao longo do tempo. Ela nos mostrou que máquinas espalhadas pelo mundo podem se comportar como um único sistema, se alguém fizer o trabalho paciente de conectá-las, protegê-las e torná-las fáceis de usar.
Por isso, em 2024 fundamos a Kinesis para construir esse grid para a computação: primeiro dentro de cada organização, para que todas as GPUs que ela usa funcionem como um único sistema, e depois entre organizações, para que a capacidade ociosa chegue a quem precisa dela.
Sua computação. Nossa computação. A computação de todo mundo.
Se você roda IA, tem GPUs ou simplesmente se importa com o rumo da computação, adoraríamos falar com você.
Baris Saydag
CEO e CTO
Hamza Ak
COO
Toshihito Kikuchi
Engenheiro-chefe
David Ding
Head de UX
Entre em contato
Fale com as pessoas que estão construindo isso.
Clientes
Conte o que você roda e onde. Diremos com honestidade se a Kinesis se encaixa, e onde não se encaixa.
Fale com a gente →Investidores
Para onde a Kinesis está indo e como planejamos construir o Grid para a computação do mundo.
Relações com investidores →Imprensa
Entrevistas, briefings e contexto sobre o mercado de computação.
Contato para imprensa →